外观
Too many open files:高并发服务器 fd 耗尽,从排查到解决的完整流程
序言
高并发服务器经常会遇到,CPU 利用率突然 100%,日志里出现 Too many open files 错误。原因是:进程的 fd 耗尽了,accept 开始失败。
而 accept 失败,在 LT 和 ET 两种触发模式下的表现完全不同,解决方案也不一样。
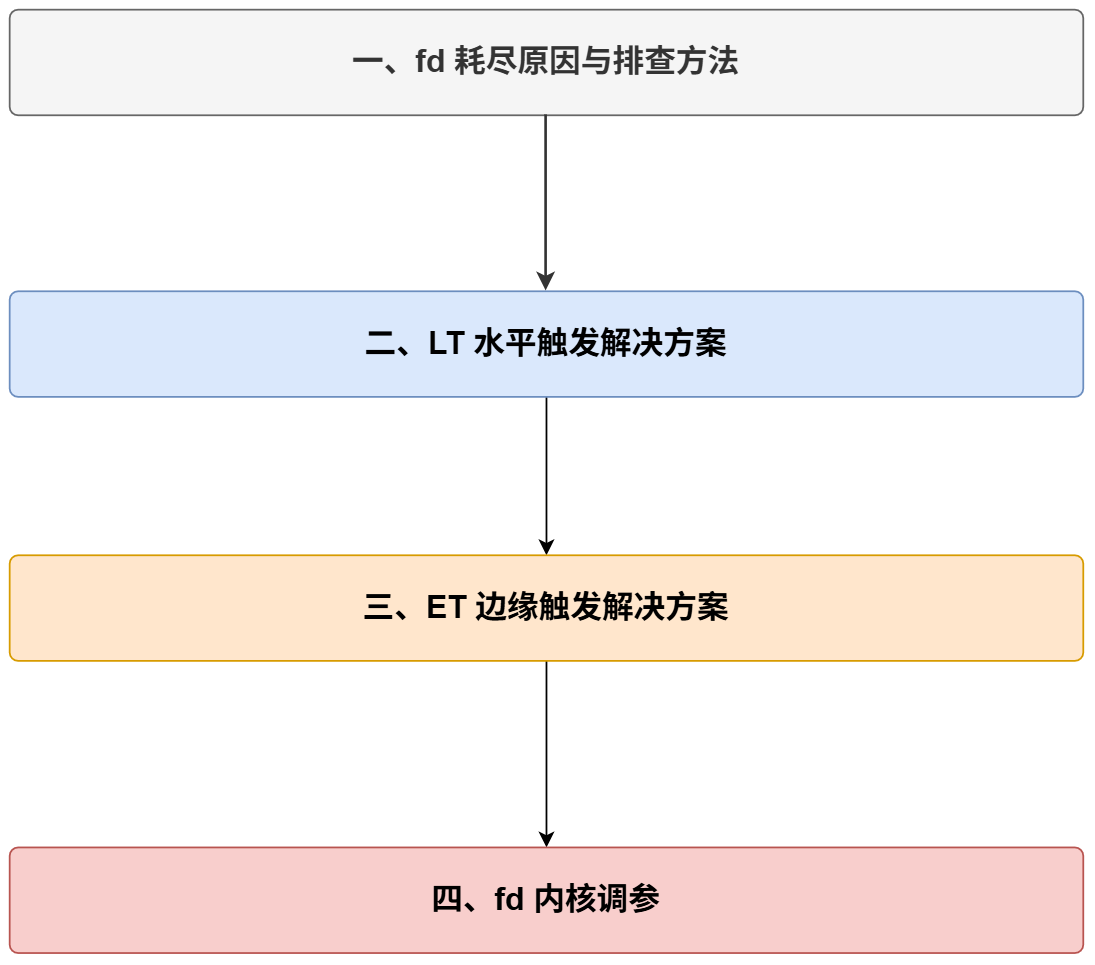
读完这篇,你会知道 fd 耗尽原因、耗尽之后有什么影响、如何排查 fd 耗尽、解决方案是什么。当你再看相关网络库时,就能理解网络库为什么这么做了。
一、fd 耗尽之后,服务器会变成什么样?
先看一个真实案例。一台服务器,某天开始有新用户反馈连不上。登录机器排查,进程还在运行,没有崩溃、没有高负载,已经在线的那批用户收发消息一切正常。
服务器没有挂,老用户正常,只有新用户进不来。
老用户都正常,为什么只有新用户连不上?
因为出问题的不是收发数据,是建立连接的那一步,连接 fd 耗尽了,导致服务器无法处理客户端连接。
每条已经建好的连接都占着一个 fd,这个 fd 是它建立的时候分配的,之后读写都用它,不需要再申请。所以哪怕进程 fd 耗尽了,这些连接照样收发正常。
而新连接就不一样了,得为它分配一个新的 fd,不然连接第一步就被挡住。
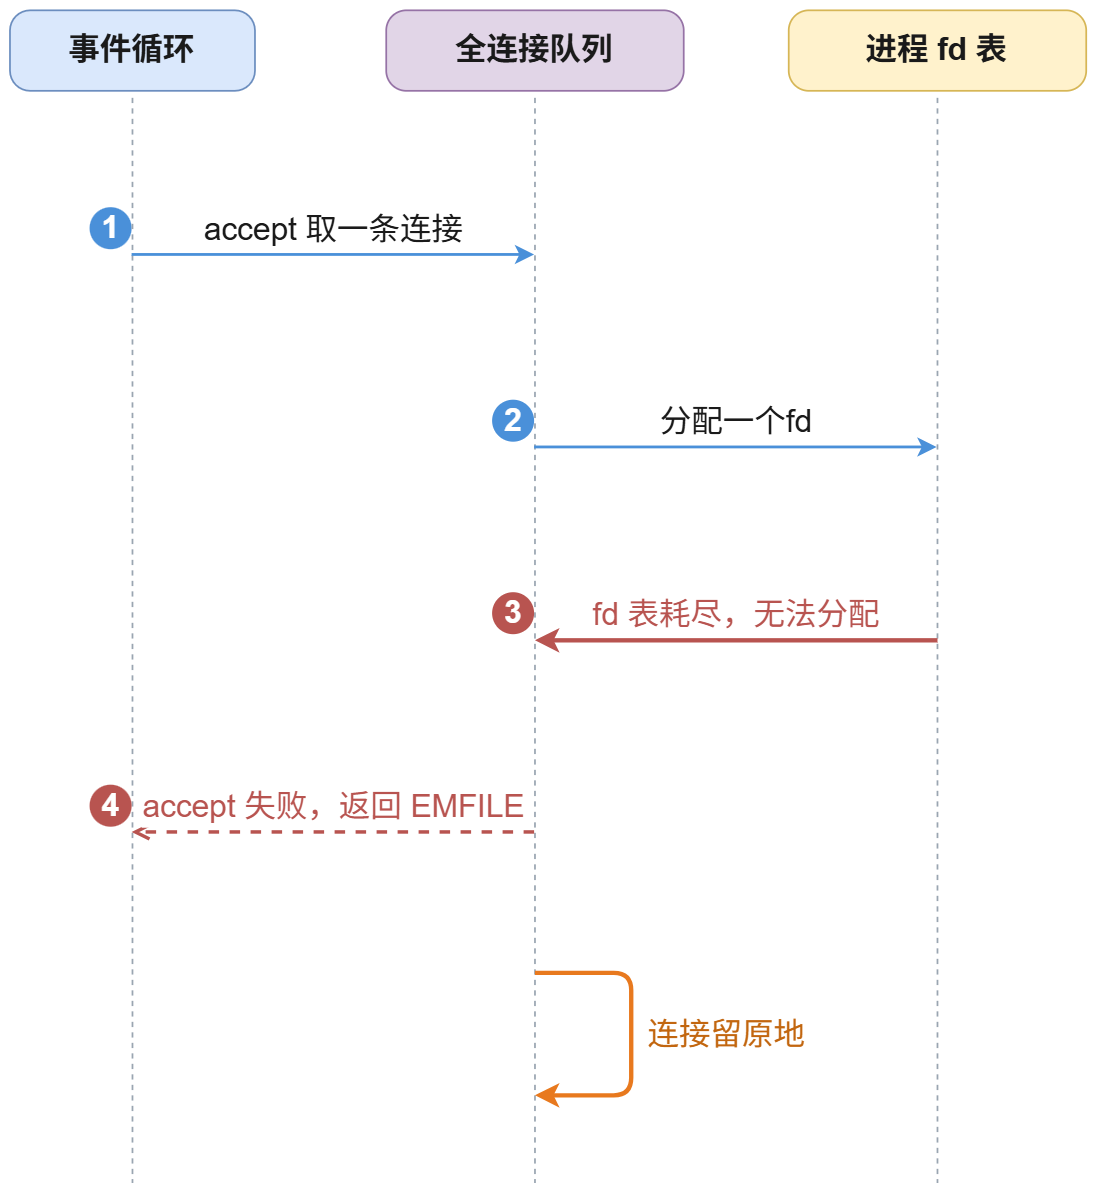
要看清卡在哪一步,得先看 accept 到底做了什么。它做的是两件事:
- 从内核的全连接队列里取出一条已经完成三次握手的连接;
- 在本进程的 fd 表里给这条连接分配一个新的 fd,把这个 fd 返回给调用方。
内核给每个监听套接字维护了两个队列:
- 半连接队列:存放三次握手还没做完的连接;
- 全连接队列:存放三次握手已经完成、正等着被
accept取走的连接。
accept 取的是全连接队列。要从全连接队列中获取一个连接,需要为它分配一个 fd。每个进程,内核都会为它维护一个 fd 表,用于记录进程打开了哪些 fd。fd 表容量是有限制的。一旦 fd 表满了就分配不出来。这时候 accept 返回 -1,错误码是 EMFILE,也就是经常看到的 Too many open files。
什么原因会导致进程的 fd 耗尽呢?
进程 fd 耗尽的原因是什么?
fd 耗尽的原因是连接数太多了。通常分以下几种情况
- 自身占用: 一个事件循环要占三个:epoll 自己的 fd、跨线程唤醒用的事件通知 fd, 也就是 eventfd、定时器用的 timerfd。再加监听 fd、日志文件、配置文件。创建几十个 I/O 线程就要占用一部分 fd
- 连接放大成两个: 网关、代理每接一条客户端连接,还要建一条到后端服务器的连接。同样的上限,能接的客户端连接数直接砍半
- CLOSE_WAIT 堆积: 对端已经关闭,自己这边没走完关闭流程,不收也不发,fd 占用着一直不释放。
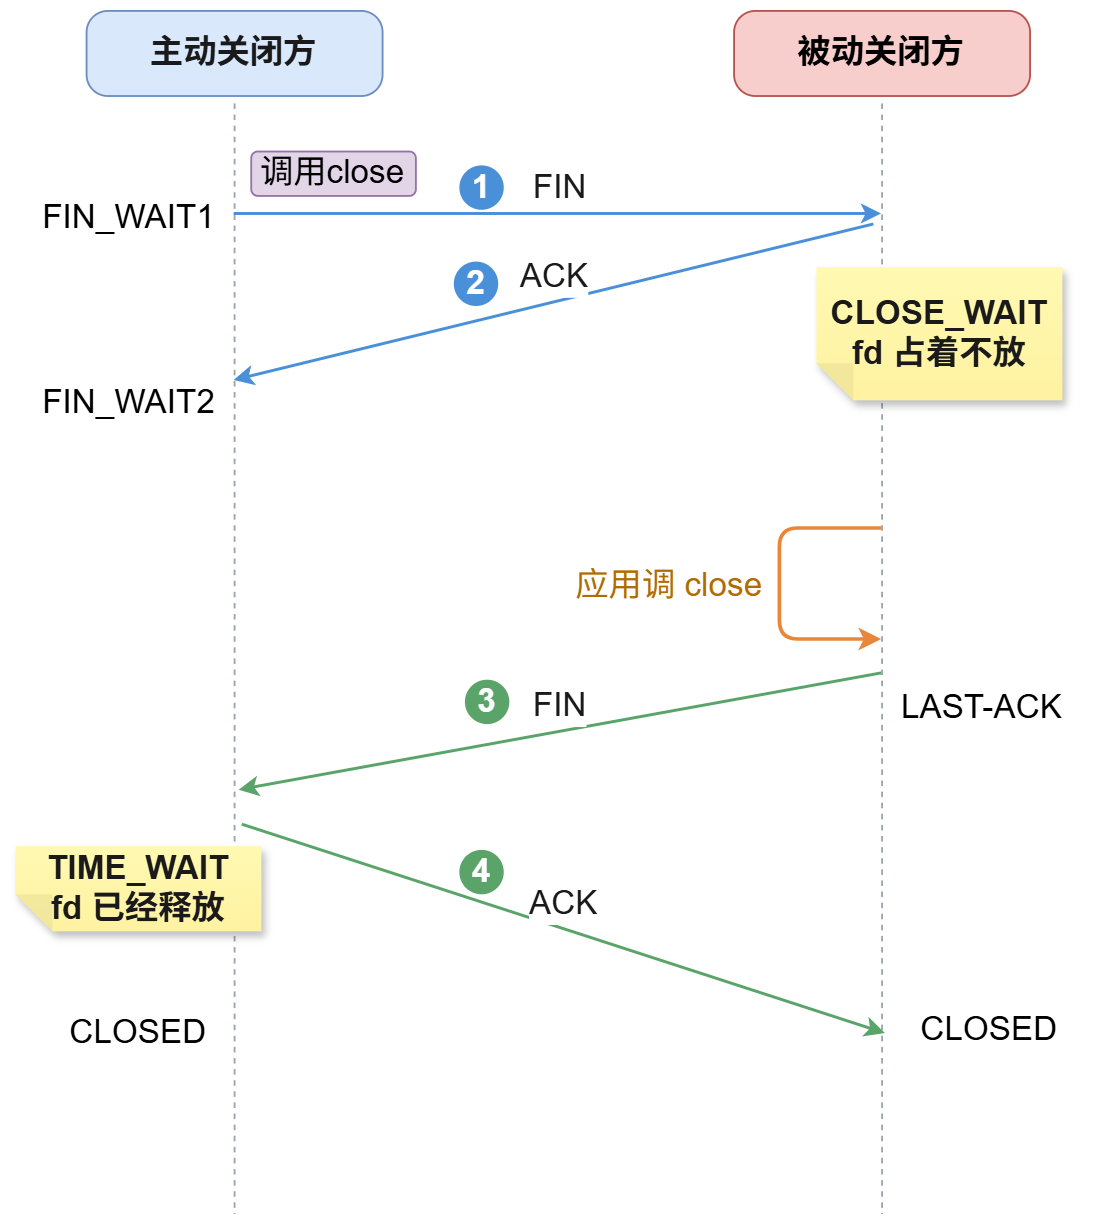
TIME_WAIT 不占 fd,占 fd 的是 CLOSE_WAIT。
TIME_WAIT 是主动关闭方在 close 之后进入的状态,fd 早就还回去了,它占的是内核里的连接控制块和本地端口;
CLOSE_WAIT 出现的原因恰恰是应用层没有调 close,fd 一直挂在那里。
- fd 泄漏: 打开之后某条分支忘了关,析构中忘了关闭 fd。fd 泄漏很难在测试阶段发现。上线之后一天涨一点,需要长时间才能发现。因此有必要提前做好 fd 使用监控。
- 只建连不发数据攻击: 恶意攻击,只发建立连接请求,连接建立后不发送任何数据,导致进程的 fd 耗尽
真遇到 fd 耗尽时,我们如何排查呢,如何才能确定真的是 fd 耗尽呢?
如何排查 fd 耗尽呢?
如何排查 fd 耗尽呢?
可以通过 strace 命令,查看进程当时的系统调用情况,例如strace -c -p $(pgrep 进程名),当 fd 耗尽时,accept 系统调用必然失败的,可以看这个系统调用的 errors 失败数是不是一直在上涨。
例如 server 这个进程,出现了 157759 次 accept 系统调用,其中 errors 就失败了 157759 次,所有的 accept 全部失败了
[root@VM-12-13-centos ~]# strace -c -p $(pgrep server)
strace: Process 1394429 attached
^Cstrace: Process 1394429 detached
% time     seconds  usecs/call     calls    errors syscall
------ ----------- ----------- --------- --------- ----------------
 41.02    1.463122           9    157759           write
 30.81    1.098950           6    157759           epoll_wait
 28.17    1.004998           6    157759    157759 accept
------ ----------- ----------- --------- --------- ----------------
100.00    3.567070           7    473277    157759 total
有时候系统调用非常多,会有些干扰,无法一下子看出是 accept 问题,此时可以排除无关的系统调用,只看网络方面的系统调用。strace -c -e trace=network -p $(pgrep 进程名)
[root@VM-12-13-centos ~]# strace -c -e trace=network -p $(pgrep server)
strace: Process 1625934 attached

^Cstrace: Process 1625934 detached
% time     seconds  usecs/call     calls    errors syscall
------ ----------- ----------- --------- --------- ----------------
100.00    0.297664           6     45710     45710 accept
------ ----------- ----------- --------- --------- ----------------
100.00    0.297664           6     45710     45710 total
accept 失败,也不一定是 fd 耗尽,如何进一步确定呢?
依然使用 strace,只查看 accept 系统调用,并查看 accept 返回的错误码。 strace -p $(pgrep 进程名) -e trace=accept
可以看出 accept 系统调用的错误码 errno 为 EMFILE,也就是 Too many open files
[root@VM-12-13-centos ~]# strace -p $(pgrep server) -e trace=accept
accept(3, NULL, NULL)                   = -1 EMFILE (Too many open files)
accept(3, NULL, NULL)                   = -1 EMFILE (Too many open files)
accept(3, NULL, NULL)                   = -1 EMFILE (Too many open files)
accept(3, NULL, NULL)                   = -1 EMFILE (Too many open files)
accept(3, NULL, NULL)                   = -1 EMFILE (Too many open files)
accept(3, NULL, NULL)                   = -1 EMFILE (Too many open files)
如果此时我们通过 ss 命令,查看进程监听的端口,例如进程监听 9527 端口,可以看出这个监听套接字的全连接队列, 也就是 Recv-Q, 会非常大,说明应用层没有 accept 从全连接队列取走连接,导致队列堆积。
ss -lnt 'sport = :9527'
[root@VM-12-13-centos ~]# ss -lnt 'sport = :9527'
State                 Recv-Q                Send-Q                                Local Address:Port                                 Peer Address:Port                Process
LISTEN 886 1024 0.0.0.0:9527 0.0.0.0:*为了方便大家实操,我把排查过程中所涉及的demo示例,放到了gitee上,感兴趣的可以从gitee下载。自己运行看看效果,感受会更深。
https://gitee.com/apelifexu/linux-network
fd 耗尽,对客户端有什么影响?
服务端 fd 耗尽,但客户端的 connect 是成功的。客户端已经完成了建立连接的过程。
三次握手全程由内核完成。客户端发 SYN,服务端内核回 SYN+ACK,客户端再回 ACK,这条连接就建立了,内核把它放进服务端的全连接队列。整个过程里,服务端的应用进程没有参与任何一步。
所以服务端有没有调 accept、调了有没有成功,在客户端这一侧看不出任何差别。
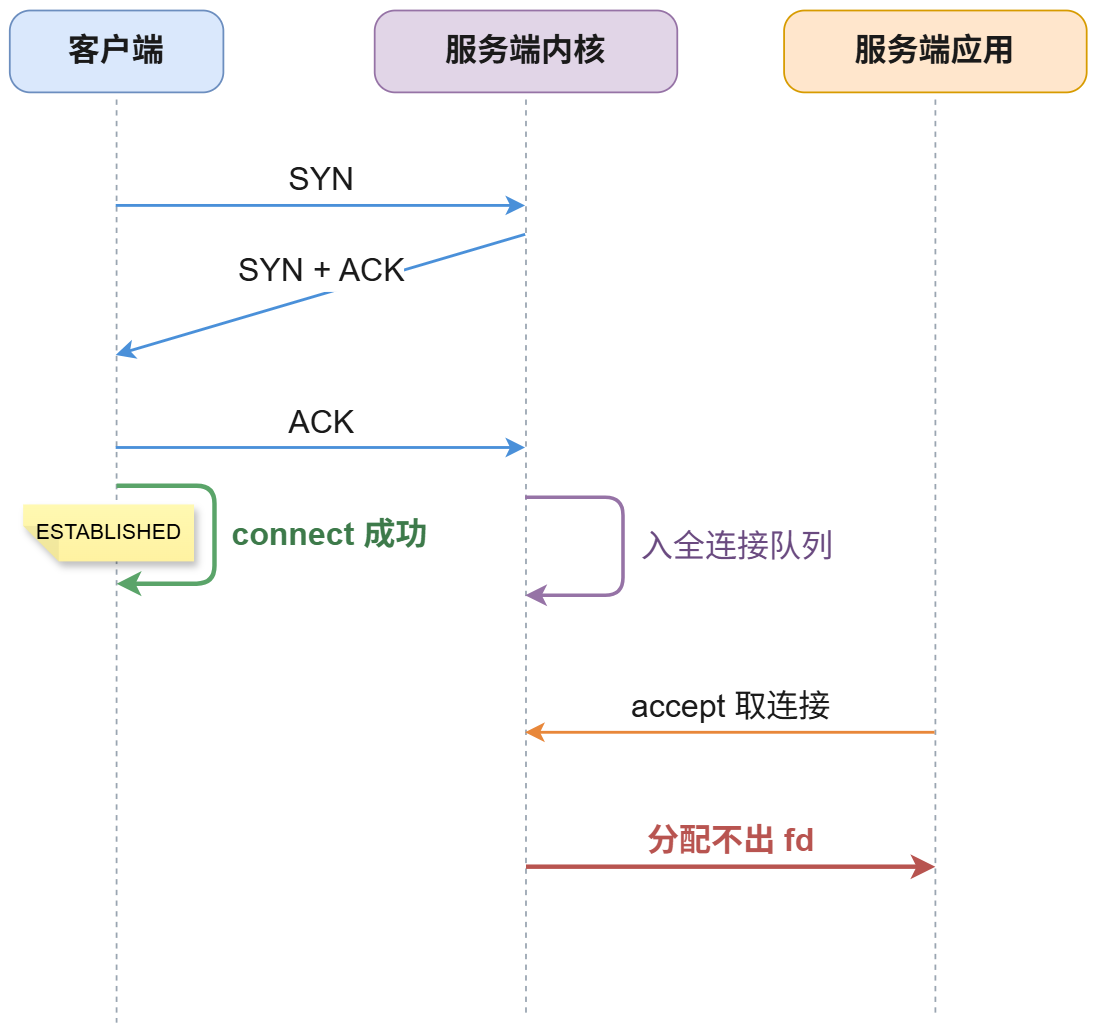
它拿到的是一条状态完全正常的连接,然后开始发请求、等回包。于是客户端观察到的是两种现象之一:
- 连接刚建立就被断开:服务端把这条连接从队列里取出来又立刻关掉,客户端这边
read返回 0,或者收到 RST 之后报ECONNRESET;之所以服务器取出连接又立马关闭,是因为 fd 耗尽了,此时进行的是降级处理,是一种兜底方案。 - 连接一直在,什么都收不到:服务端压根没取走这条连接,它一直躺在全连接队列里。客户端发出去的请求进了服务端的内核接收缓冲区,没有任何应用代码去读,最后客户端自己超时。
排查线上问题的时候,这个特征很有辨识度:
不是连不上,是连上了没反应。如果监控显示 connect 成功率是百分之百,但请求超时率很高,
accept这一环就值得查一查。
fd 耗尽,对服务端有什么影响?
- 全连接队列打满,无法处理增量的客户端的连接
- LT 触发方式下,空转的 CPU,引发 CPU 高负载,直接导致整个系统慢速
连接还留在队列里,LT 模式下会怎样?
LT 水平触发方式下,会一直通知,而且是不停地通知。
对监听 fd 来说,只要队列里有连接等着被取走,就算可读,就会一直触发。
LT 水平触发下。accept 返回 EMFILE,一条连接都没取走,下一轮 epoll_wait 照样返回这个监听 fd。此时就相当于一个死循环,CPU 一直空转高负载。
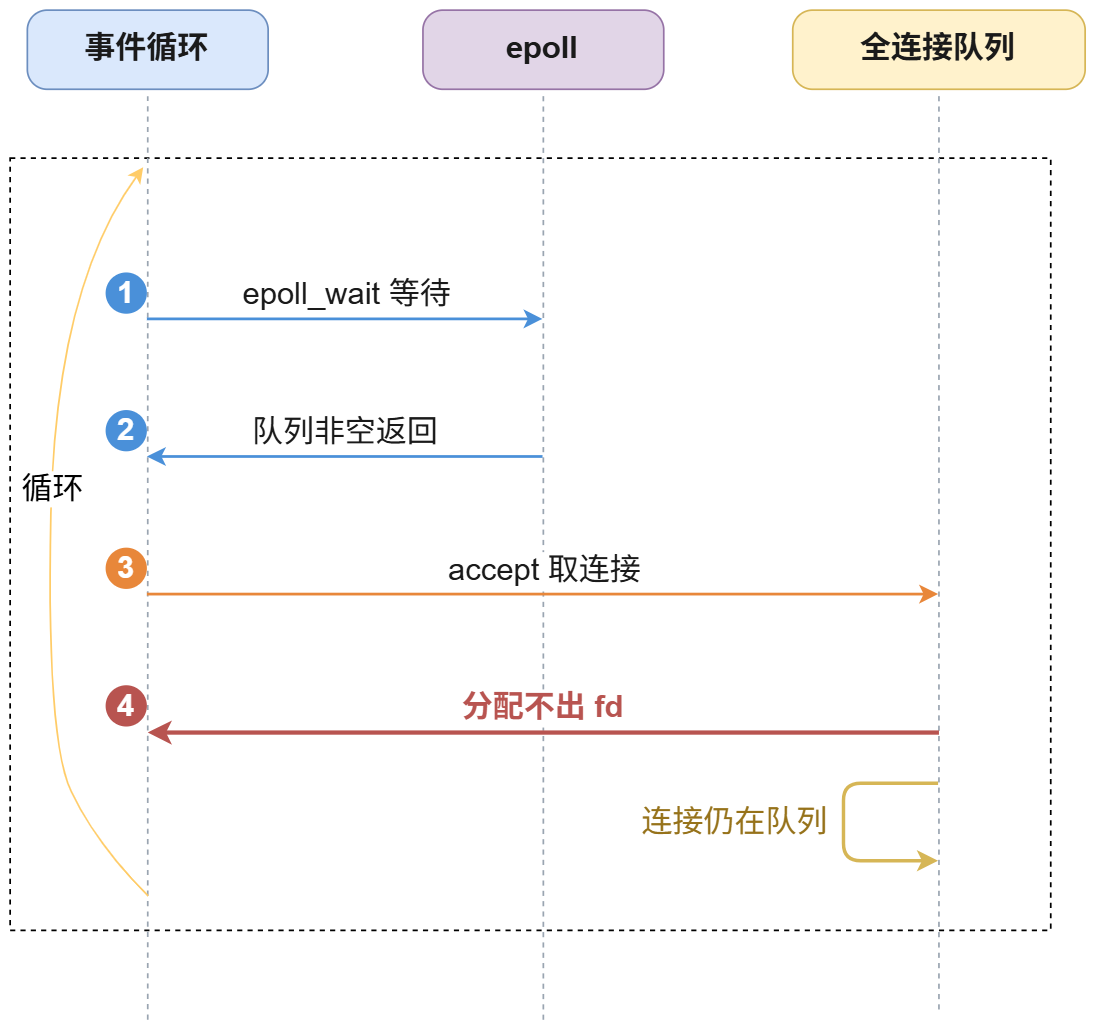
epoll_wait返回监听 fd 可读;- 调用
accept,返回EMFILE; - 连接仍然留在全连接队列里,队列长度不变;
epoll_wait又触发,重新返回。
epoll_wait 从头到尾没有阻塞过一次,事件循环空转,单核 CPU 直接跑满。出现 Too many open files 错误
更麻烦的是,这个事件循环上还挂着别的连接。它把 CPU 全花在空转上,消耗在 epoll_wait 系统调用上,那些本来不受影响的存量连接,处理延迟也跟着涨。故障从"新连接进不来"扩大成了"所有人都变慢"。
好在这个状态是能自愈的:只要有连接关闭、fd 腾出来了,下一轮 accept 就成功,全连接队列空后,就会恢复到正常状态。
连接还留在队列里,ET 模式下会怎样?
不会空转,对 CPU 消耗没什么影响。不过情况会更糟。
ET 的边沿产生在内核往全连接队列里放进一条新连接的那一刻。每完成一次三次握手,就产生一次边沿,epoll_wait 把监听 fd 返回一次。
accept 失败没取走连接,就不会产生边沿。得等下一条新连接完成触发。
低峰期新连接稀疏,就是无限期搁置:客户端连着,服务端不动,两边都不报错。
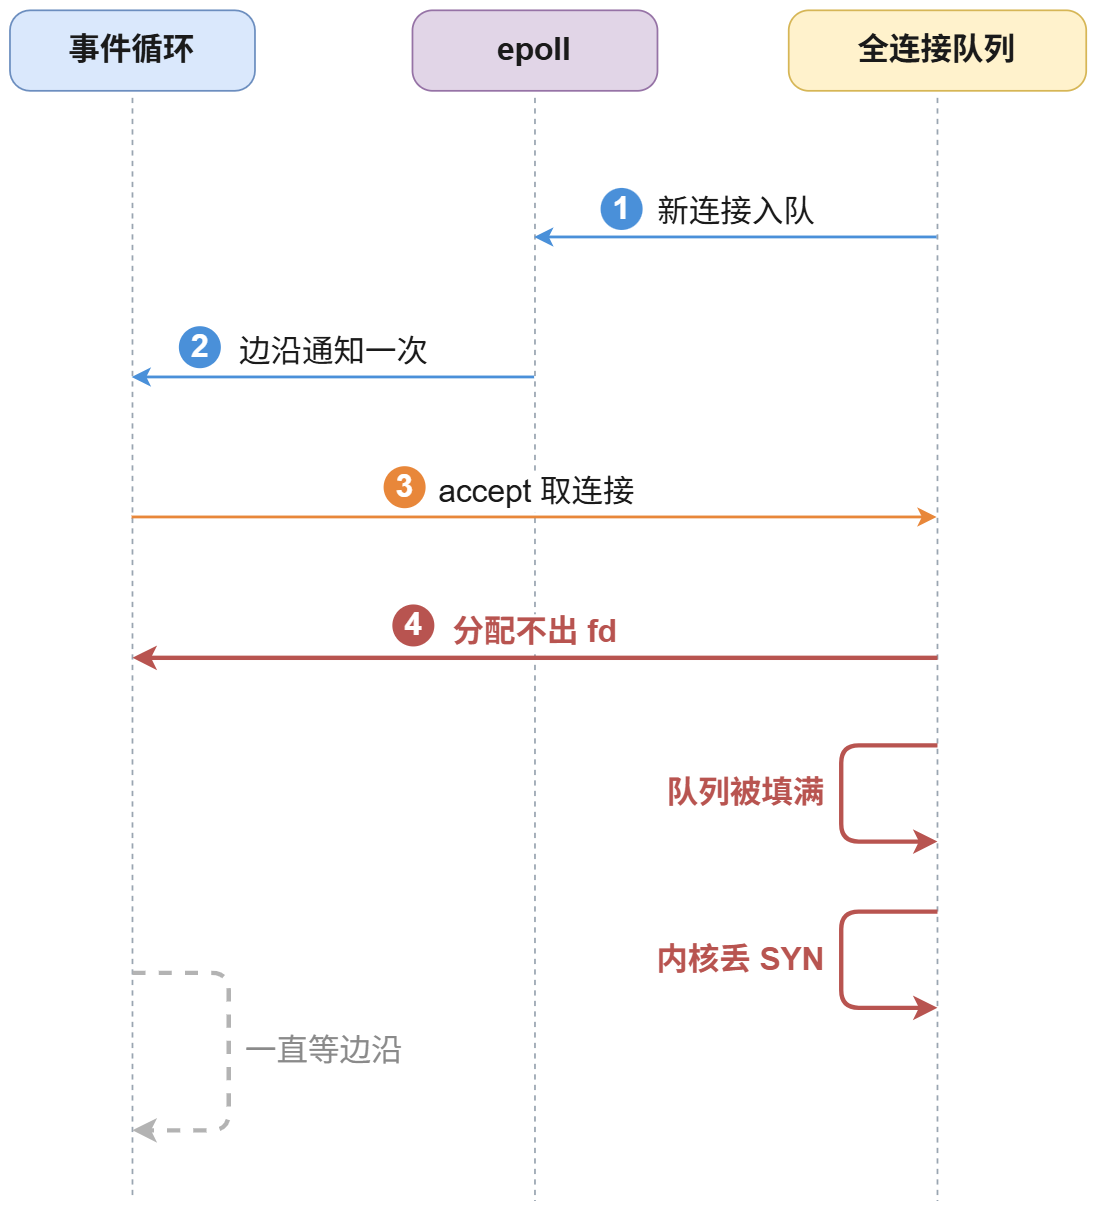
更糟的是还有一个无法恢复的场景。全连接队列的长度是有上限的,队列被填满之后,内核开始丢弃新来的 SYN,握手完不成,也就不再有任何新的边沿产生:
没有新连接就没有边沿,没有边沿就不会去
accept,不accept队列就一直是满的,队列满就更不可能有新连接。这时候哪怕业务侧关掉了一批连接、fd 已经空出来,服务也不会恢复,只能重启。
两种模式的表现放在一起对照,差别一目了然:
| 对照项 | LT 水平触发 | ET 边缘触发 |
|---|---|---|
| CPU 表现 | 单核跑满 | 无影响 |
| 日志表现 | 高频刷错误 | 一片安静 |
| 存量连接 | 被空转拖慢 | 完全不受影响 |
| 排队中的新连接 | 一直有机会被处理 | 搁置,等新连接捎带唤醒 |
| 全连接队列填满之后 | 仍在空转,fd 一释放就恢复 | 不再产生边沿,不会自愈 |
| 好不好发现 | CPU 报警直接指到位 | 监控上几乎看不见 |
二、LT 水平触发的解决方案:预留占位 fd,把连接从队列里摘掉
fd 耗尽导致
accept失败,而想让accept成功,得先有一个 fd。
fd 耗尽时,没有任何办法取得一个新的,因此唯一的做法是,提前预留一个。
具体做法:服务启动时就打开一个文件,这个 fd 一直不关闭,平时也不做任何读写,专门留着应急用。
一般选 /dev/null,读写都不产生实际开销,也不占内核的缓冲区。
这个提前占住的 fd,一般叫占位 fd。那这个占位 fd,遇到 fd 耗尽,EMFILE 的时候怎么处理?
占位 fd 是如何使用的?
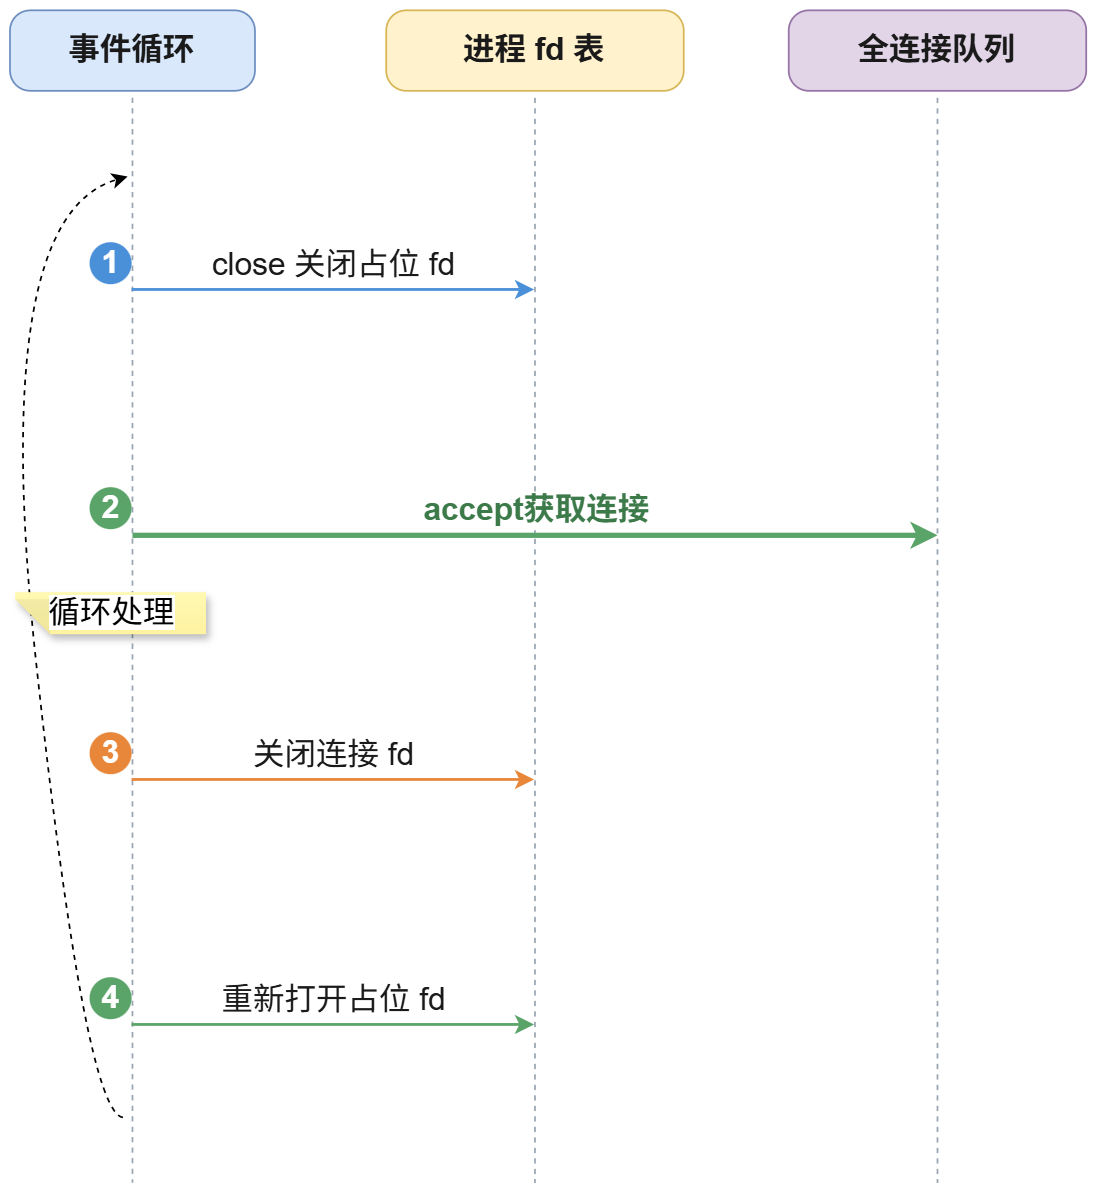
- 关掉占位 fd:关闭后,进程的 fd 表里多出一个空闲的 fd。这不是凭空变出一个 fd,而是把提前占位的那个腾出来;
- 执行 accept 时使用这个空闲的 fd:从全连接队列里取一个连接。这一次调用会成功,因为刚刚空出了一个空闲的 fd;
- 立刻关掉刚
accept出来的连接:此时对端收到明确的断开;accept出来的这个 fd,立马就把它关掉了,它真正的作用不是接受连接。这一步真正干的事,是把这条连接从全连接队列里移走。等队列没有数据时,epoll_wait就不再返回监听 fd,CPU 也不会空转导致高负载。 - 重新打开
/dev/null,把占位补回来:为下一次做准备,如果不补回来,再次遇到EMFILE就无计可施了。
连接后又立马关闭,是一次有意的服务降级。 这条新连接被明确拒绝了,客户端会立刻收到失败,可以马上去重试别的节点。这比让它挂在队列里干等超时要好,更比让整个进程的 CPU 打满、把已经在服务的连接一起拖垮要好。这套做法的取舍就一句话:牺牲增量连接,保住存量连接和整个进程。
CPU 从这里降下来,靠的是队列长度变了,不是靠
accept成功了。
一轮下来只摘走了一条,可队列里可能还堆着几十条,剩下的怎么办?
为什么一次只取一个连接?
因为 LT 会兜底。
这一轮只取出一条连接,队列里还剩多少都没关系。剩下的连接让"队列非空"这个条件继续成立,下一轮 epoll_wait 照样把监听 fd 返回出来,事件循环再调一次处理函数,再取一条连接。多次下来,队列迟早会被取空。
只要全连接队列里还有连接,它就一直触发,不存在"漏掉一次通知就再也收不到"的情况。
代价是每拒绝一条连接,要多走一次 epoll_wait 的往返。相比之下,在循环里一次把队列取空显然更省系统调用。但对拒绝连接这条路径来说,省这点开销不重要,代码简单、不会漏才重要。
这也是 LT 这条路最省心的地方:就算处理逻辑写漏了,也不会静默失败。 队列里的连接没被取走,epoll_wait 就一直返回,CPU 一直是满的,故障在监控上立刻就能看见。
不过这个方案也存在一些问题,需要特别注意。
这套方案还有什么问题?
有两种情况:
- 腾出来的名额被抢走了:第一步关掉占位 fd 之后、第二步
accept之前有一个空窗,进程里别的地方如果恰好在这一瞬间开了新 fd,这个名额就被拿走了,第二步照样返回EMFILE;
在多线程程序里完全可能发生,尤其是开了 SO_REUSEPORT、多个线程各自持有监听套接字的时候。
好在后果可控:这一轮取连接失败,队列里那条连接没被取走。此时的 fd 是一个无效的 fd,关闭一个无效的 fd 会失败,错误码为 EBADF,接着重新打开占位 fd 还是能成功打开,下一轮 epoll_wait 返回再试一次就是了。
- 整机 fd 耗尽,也就是 ENFILE:关掉占位 fd 腾出来的名额,会被机器上别的进程立刻拿走,怎么试都不一定轮得到自己。
虽然有这么两个问题,但作为降级,作为兜底方案,还是很多网络库在使用。muduo, skynet 就是这么处理的。
三、ET 模式下的解决方案:移除监听事件
ET 边缘触发方式下,依然可以使用和 LT 水平方式一样的方案,使用占位 fd。不过 epoll_wait 返回 监听套接字可读时,需要循环 accept,直到返回 EAGAIN
关掉占位 fd、accept 取出一条、关掉它、重新打开占位 fd,下一轮接着来,一轮循环拒绝一条,直到队列被取空。
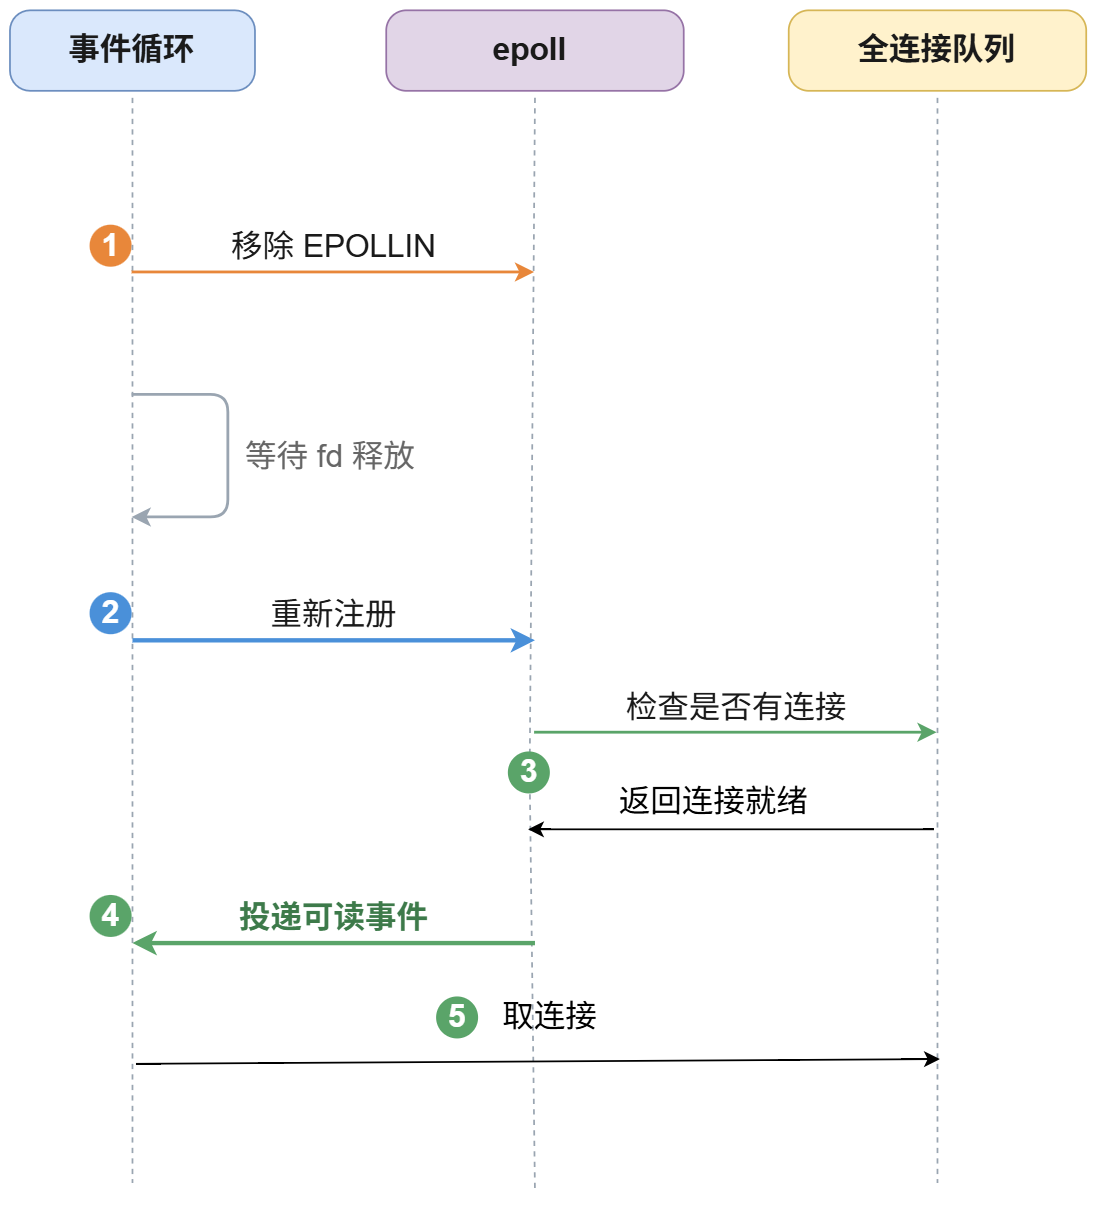
除此之外,还有一种方案,当 accept 返回 EMFILE 时,可以将监听 fd 从 epoll 中移除。我们来看下这种方案是如何处理的。
把监听 fd 的读事件移除,稍后重新注册
遇到 EMFILE 就把监听 fd 的 EPOLLIN 从 epoll 中移除,之后不管来多少新连接,事件循环都不会再因为这个 fd 被唤醒。
移除方式有两种,效果一样但有细微差别:
- 用
EPOLL_CTL_DEL把整个 fd 从 epoll 里删掉:最彻底,但这段时间里监听 fd 上的错误事件也收不到了; - 用
EPOLL_CTL_MOD保留 fd、只去掉 EPOLLIN:同样是一次系统调用,错误事件不会丢,更稳妥一些。
那什么时候重新将监听 fd 注册到 epoll 中呢?
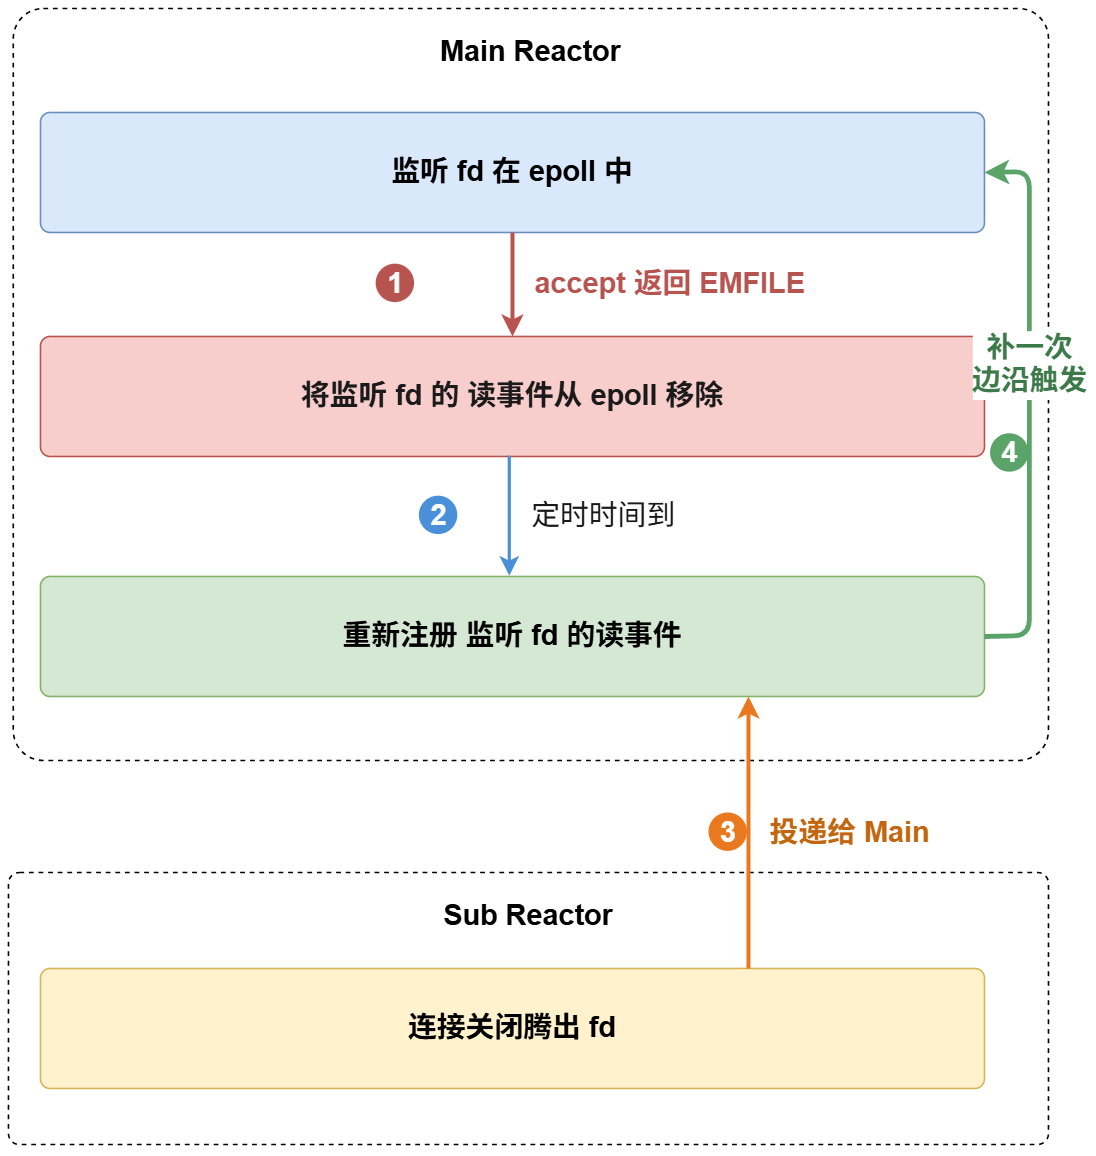
通常有两种方式:
定时器触发:移除读事件的同时挂一个定时器,隔几十毫秒重新注册一次。还是 EMFILE 就再移除。实现简单,不侵入连接的生命周期。缺点是恢复慢半拍,需要等到定时器触发,延迟大。
连接关闭时驱动:在连接析构、fd 真正被 close 时,判断当前监听 fd 是不是处于被移除状态,如果是就把监听 fd 读事件注册回去。优点是恢复及时,fd 重新注册立马就能触发。
真正执行,会采用两者的结合。定时器兜底,连接关闭时驱动。
定时器负责保底,连接关闭负责及时。两条各有各的不足,所以要结合起来。如果只用定时器,延迟很大;只用连接关闭方案,一旦没有连接关闭,那就真的卡死了,无法再处理新连接。
还有一个跨线程的细节容易踩坑。 主从 Reactor 模型里,监听 fd 归 Main Reactor 处理,连接 fd 却分散在各个 Sub Reactor 线程处理。重新注册监听 fd 这个操作必须封装成一条消息,然后投递到 Main Reactor 线程去执行,不能在 I/O 线程里直接执行。
重新将监听 fd 注册到 epoll 中,读事件会重新通知吗?
答案在重新注册这个动作本身。epoll_ctl 在 EPOLL_CTL_ADD 和 EPOLL_CTL_MOD 的时候,会当场检查一次这个 fd 的就绪状态,如果此刻已经就绪,就直接把事件投递出去
重新注册相当于人工补上了一次边沿。哪怕全连接队列里那些连接是十分钟前进入的、只要把读事件重新注册回去,下一轮 epoll_wait 就会把监听 fd 返回出来。
ET 会丢边沿这件事,就是靠这个性质解决的。
目前使用这种方案的网络库还不少,Nginx 就是这么处理的
真遇到了 fd 耗尽,进程已经没有 fd 了,此时已经达到极限。LT 和 ET 介绍的方案,只能算是降级,是一种兜底的方案。
因此我们需要做的就是不让 Too many open files 发生,不触发兜底方案。
任何一个高并发服务器,在触发兜底前,通常都会有两种措施,防止 fd 耗尽:
连接数到达一定阈值时就拒绝连接: 进程内维护一个当前连接数的计数, 一旦连接数超过了配置的阈值,那就拒绝接入,直接关掉这条新连接。这能实时地控制 fd 的数量,避免触发兜底措施。
keep-alive 保活,清理长时间空闲的连接: 对于长时间空闲,没有数据往来的连接,就主动关闭,释放出一批 fd
有了这 2 种保障,通常能将 fd 限定在一定的范围内,留出足够的 fd,以免触发 fd 兜底方案。
四、fd 耗尽时,如何调整内核参数?
一个进程能开多少 fd,是由哪几层决定的?
由三个层面决定,任何一层卡住都会失败。
| 层级 | 名称 | 管的是什么 | 超限时的错误码 |
|---|---|---|---|
| 最外层 | fs.file-max | 整台机器所有进程的 fd 总量 | ENFILE |
| 中间层 | fs.nr_open | 单个进程能拥有的 fd 数上限 | EMFILE |
| 最内层 | soft | 本进程实际生效的限制 | EMFILE |
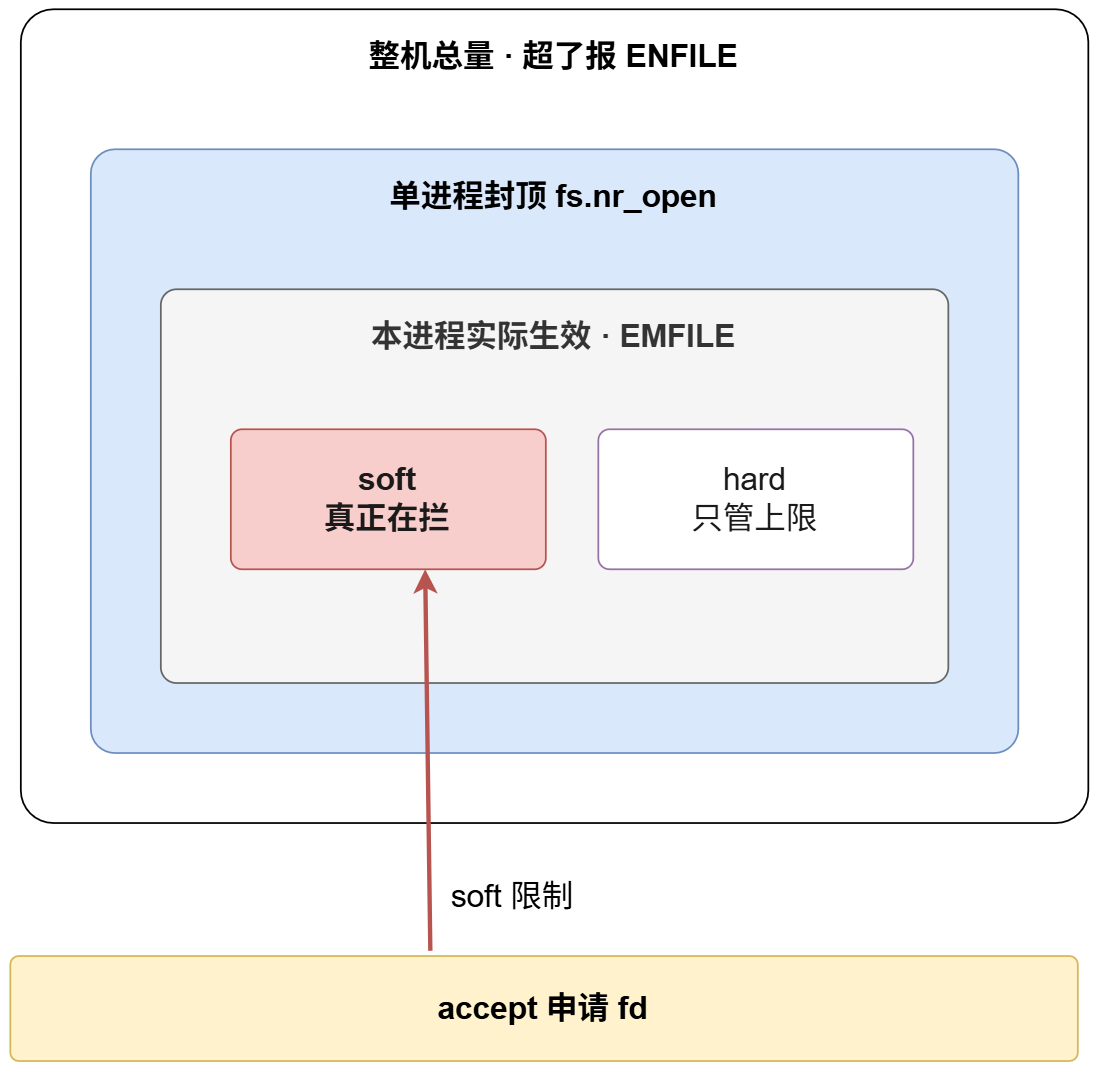
fs.file-max 管的是总量。 它是一个全局的配置,是整个内核里打开的文件对象总数。内核会根据物理内存自动算一个值,通常是几十万到几百万,一般不需要动它。遇到 ENFILE,那就是整个系统 fd 耗尽了,而不是单个进程 fd 耗尽,单个进程无法挽救
fs.nr_open 有点特别,开关是全局的,语义却是进程级的。 整台机器只有一个值,改一次影响所有进程;但它表达的意思是"任何一个进程最多能拥有多少 fd",不是"整机总共多少"。绝大多数发行版的默认值是 1048576,它是 soft 的上限。
soft 才是单个进程 fd 生效的限制,也就是 ulimit -n 看到的那个数。超过 soft 限制,就会出现 EMFILE 错误。
soft、hard、fs.nr_open 有什么关系?
soft 能调的最大上限是 hard;
hard 能调的最大上限是 fs.nr_open
因此 soft 和 hard 的最大上限是 fs.nr_open
真正限制 accept 的是 soft 还是 hard?
是 soft。
内核给进程分配 fd 的时候,只拿当前已用的 fd 编号和 soft 比较,从头到尾不看 hard。所以"fd 数量超过 hard"这个状态压根不会出现,也就谈不上超过之后会怎样。hard 唯一的作用是限制 soft 能设到多高。也就是说 soft 设置的上限是 hard
那"超过 hard 会被杀掉"这个说法是从哪来的?
是和另一类 rlimit 串台了。rlimit 分成两类,语义完全不同:
| 类型 | 代表 | 撞到 soft | 撞到 hard |
|---|---|---|---|
| 信号型 | CPU 时间、单个文件大小 | 收到信号,默认终止进程,可捕获 | 直接被杀,无法阻挡 |
| 错误码型 | fd 数量、地址空间 | 系统调用返回错误码 | 不参与检查,只控制 soft 的上限 |
CPU 时间和文件大小那两个确实是遇到"soft 信号通知、遇到 hard 挂掉",而 fd 个数属于错误码类型,不会检查 hard
如何查看进程 fd 的使用情况
如何查看进程当前 fd 的使用情况
每个进程打开了多少 fd,在 proc 目录下都有记录,可以使用ls -l /proc/$(pgrep 进程名)/fd 查看进程当前打开的 fd 列表;
也可以使用 ls -l /proc/$(pgrep 进程名)/fd | wc -l 查看当前进程打开的 fd 总数。
[root@VM-12-13-centos ~]# ls -l /proc/$(pgrep server)/fd
total 0
lrwx------ 1 root root 64 Aug 20 19:20 0 -> /dev/pts/0
lrwx------ 1 root root 64 Aug 20 19:20 1 -> /dev/pts/0
lrwx------ 1 root root 64 Aug 20 19:20 10 -> 'socket:[283515400]'

[root@VM-12-13-centos ~]# ls -l /proc/$(pgrep server)/fd  | wc -l
3
如何查看进程当前的 fd 上限是多少呢?
执行这个命令,可以查看进程当前配置的 fd 上限 soft 和 hard 分别是多少。
cat /proc/$(pgrep 进程名)/limits
[root@VM-12-13-centos ~]# cat /proc/$(pgrep server)/limits
Limit                     Soft Limit           Hard Limit           Units
Max open files            20                   20                   files
如何查看系统 fd 的使用情况
使用 sysctl -a |grep fs.file-max 可以查看整个系统,fd 配置的上限是多少
[root@VM-12-13-centos ~]# sysctl  -a |grep fs.file-max
fs.file-max = 9223372036854775807
使用 cat /proc/sys/fs/file-nr 可以查看整个系统 fd 的使用情况。
从左到右的 3 个数字,分别是: 已分配的 fd 个数 / 已分配但空闲的 fd 个数 / 系统上限(也就是 fs.file-max)
[root@VM-12-13-centos ~]#
[root@VM-12-13-centos ~]# cat /proc/sys/fs/file-nr
1504	0	9223372036854775807
如何调整进程能打开的 fd 个数?
通常有 3 种方式修改。可以使用 setrlimit,也可以使用 ulimit、或者 prlimit
setrlimit这个系统调用接受两种数据:改哪种资源、改成什么值,它从诞生起就只能改调用它的那个进程自己。这也是最常用的方式:进程启动时调setrlimit,把 soft 设置到 hard。ulimit内部使用的是 setrlimit 这个系统调用。修改的也是 soft 和 hard 。ulimit -n 65536改的是执行这条命令的那个 shell 进程,然后靠子进程继承往下传:shellfork出来的子进程完整复制这份限制,exec` 之后也保留不变。 整个 Unix 的 rlimit 模型就是这么设计的——不是把限制推给别人,而是改自己,让别人继承。要改一个正在运行的进程,得用
prlimit。修改的也是 soft 和 hard。它对应的系统调用参数里才有进程号,改完对已经在跑的服务立刻生效。线上突然报EMFILE的时候,可以先用它止损
fs.nr_open 这一层平时不用碰。只有当你需要把 hard 调整到 fs.nr_open 大小时,才将 fs.nr_open 设置成更大的值,从而让 hard 也能跟着调大
总结
进程 fd 耗尽了,accept 无法获取到一个 fd,通常有两种兜底方案。
- LT 模式:启动时预留一个 fd,遇到 fd 耗尽之后关掉它;接着使用 accept 从全连接队列取出连接;然后立马关闭 fd;重新打开占位 fd。
- ET 模式:fd 耗尽时,移除监听 fd 的读事件,靠定时器和连接关闭两条路重新注册。重新注册会当场检查就绪状态,会重新触发一次监听 fd 的读事件;
我们也可以调整内核参数,来增加进程可以打开的 fd 个数:
- fd 上限:
fs.file-max、fs.nr_open、soft, 限制进程可以打开的 fd 数。 分配 fd 时只看 soft。hard 只限制 soft 能设到多高。
可以通过 setrlimit、ulimit、prlimit 这 3 种方式调整一个进程能打开的 fd 数。 最常用的做法是,程序启动时通过 setrlimit,把 soft 设置到 hard
写在最后
fd 耗尽是高并发服务器最常见的一类故障,在你看懂了解决 fd 耗尽的 2 种兜底方案后,再去看任何一个网络库的代码,你就能理解网络库为什么那么做了。
我尽量站在读者的角度把来龙去脉讲清楚了,但每个人理解不一样。有任何疑问,可以在评论区里讨论,也可以联系作者。
如何联系作者
- 微信公众号关注高并发成长记,加入linux网络编程交流群,一起讨论。