外观
客户端收得慢,网关内存被打爆:两种背压方案讲透
序言
网关、代理等高并发服务器,通常面临上下游速度不匹配问题。网关从后端服务器读数据很快,往客户端发却很慢。那从后端读进来的数据先放哪儿?放不下了又该怎么办?
这就是业界常说的背压(backpressure),所有做转发的高并发服务器都面临这样的问题。业界通常有两种解决方案。
读完这篇,当你在看相关网络库代码时,就能做到知其所以然。
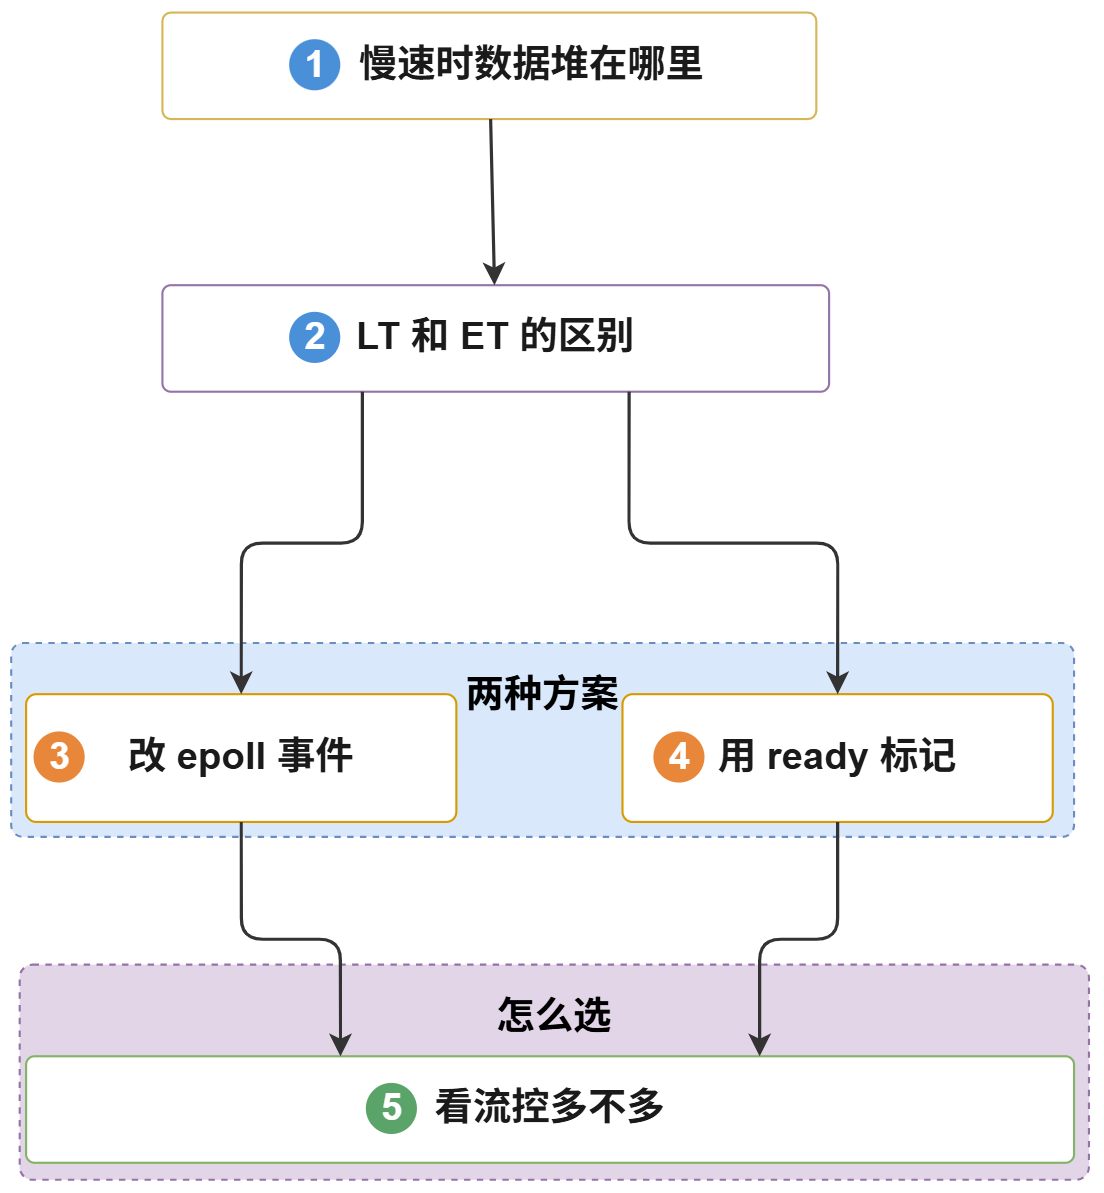
一、客户端收得慢,数据堆在哪里?
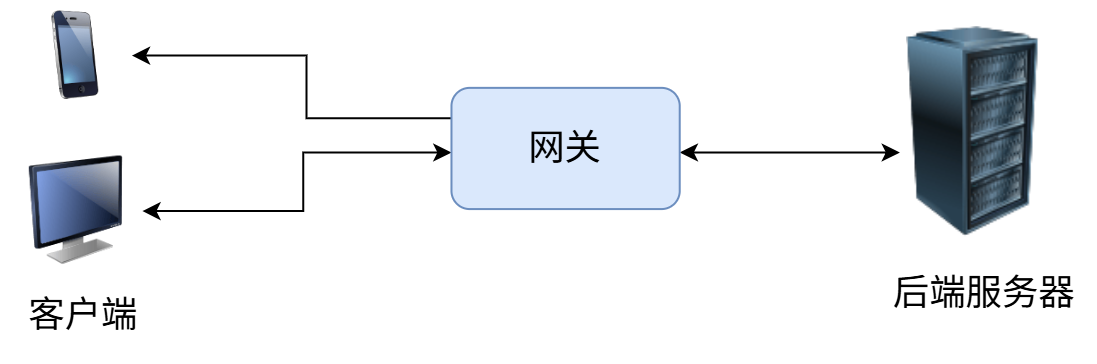
网关作为转发服务器,客户端会和网关建立连接,网关也会和后端服务器建立连接。它从后端服务器接收数据,然后发送给客户端。
当两条连接速度差不多的时候,从后端收到多少就转发多少。
真正的麻烦在两边速度不匹配的时候。而这恰恰是网关经常要面对的:后端服务器在机房里,客户端在移动网络上,两者的带宽差出一两个数量级是常态。
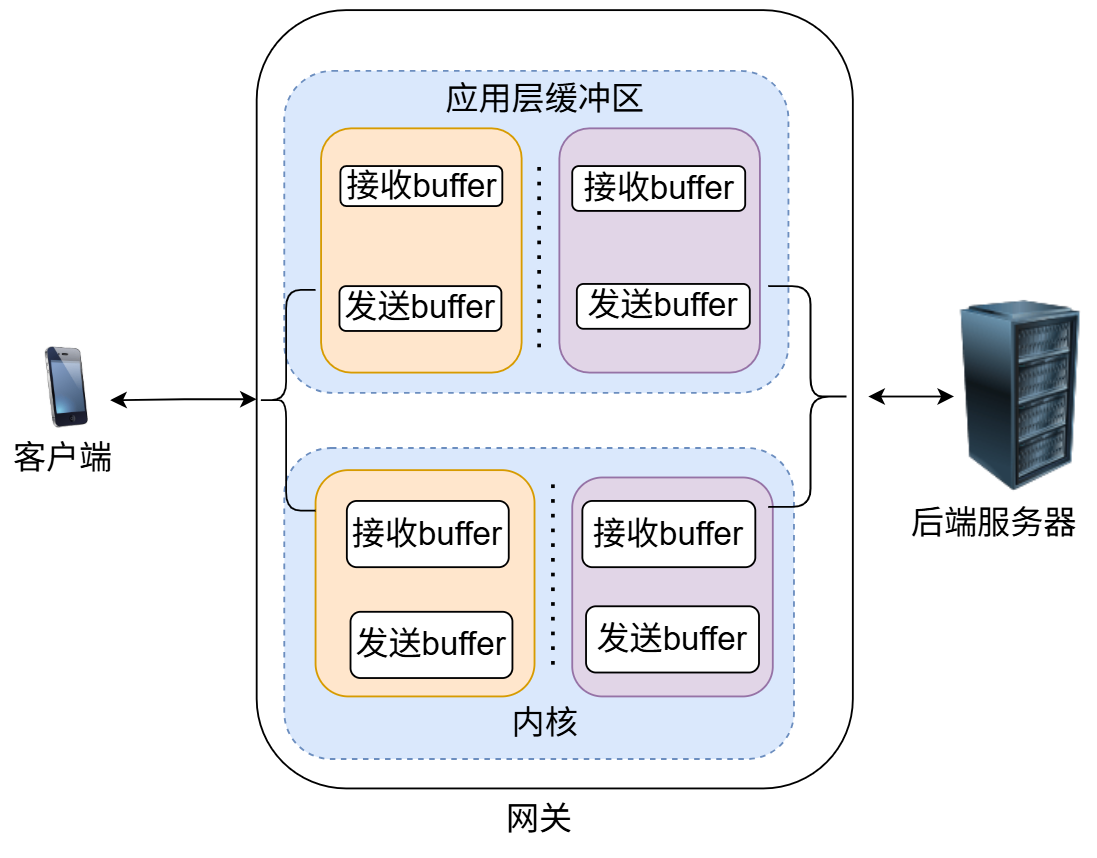
客户端收得慢,数据会积压在哪个缓冲区?
网关不止一个缓冲区。网关和客户端,网关和后端,这两条连接各自都有内核收发缓冲区。另外,网络库还会给每条连接配一个应用层接收缓冲区和应用层发送缓冲区。
客户端方向: 从后端方向,应用层接收缓冲区中读取数据,直接 write 发给客户端。如果发送不完的数据,会拷贝到客户端方向的发送缓冲区中。等客户端方向写事件触发,再将应用层发送缓冲区数据发给客户端。
后端方向接收快,客户端方向发得慢。数据持续地保存到客户端方向的应用层发送缓冲区,这个缓冲区就这么一路涨上去。
后端服务器方向: 后端服务器方向接收没有任何变化,还是按原来的速度接收。网关刚接收到一批数据,保存到应用层缓冲区中,下一批又从后端服务器读进来了。
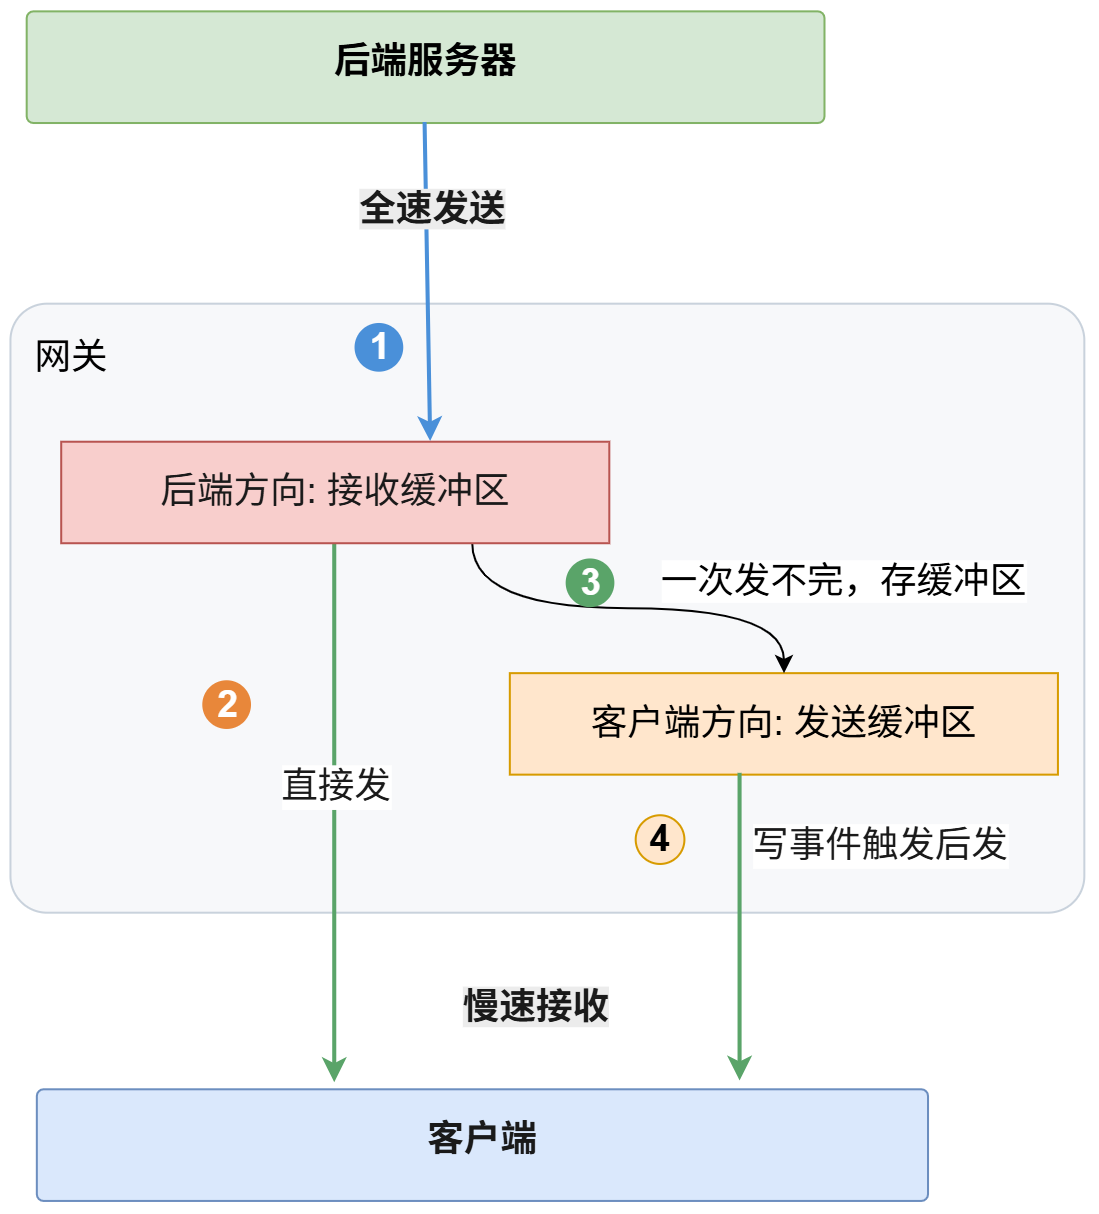
从图中可以看到,一旦客户端慢速,发送不完的数据,就会积压到客户端方向的应用层发送缓冲区中,每一轮添加一批,导致发送缓冲区内存暴涨。
应用层发送缓冲区一直涨下去会怎样?
客户端方向,应用层发送缓冲区一直涨下去,会导致内存耗尽,进程被系统的 OOM 机制杀掉。
网络库通常使用无界缓冲区,没有上限,你存多少它收多少。单看一条连接,积压 1 MB 不算什么。可网关服务器上跑的不是一条连接,10 万个慢速客户端每个积压 1 MB,加起来就是 100 GB。
那把这个缓冲区做成有上限的,满了就丢数据行不行?
不行。丢掉的是已经从后端服务器收下来的字节,TCP 那一侧已经进行了 ACK 确认,后端服务器不会再发第二遍。如果丢弃部分,客户端收到的就是不完整的数据。
更关键的是,一直存下去,问题一点没解决。后端服务器的发送速度不会因为网关在存数据就降下来。存,只是把内存耗尽的时刻往后推一推。
要真的解决,得让后端服务器慢下来。可后端服务器位于另一台机器,网关没法直接命令它。如何处理呢?
如何降低后端服务器的发送速度?
要让后端服务器慢下来,网关不去读数据,就能倒逼后端将发送速度降下来。
我们来看下这个过程:
如网关收到后端的数据时,不去从内核读数据, 此时什么都不做。后端方向那条连接的内核接收缓冲区就会被填满,网关给后端服务器发送一个零窗口通告。
这里走的是 TCP 自带的流量控制,整条链路是这样的:
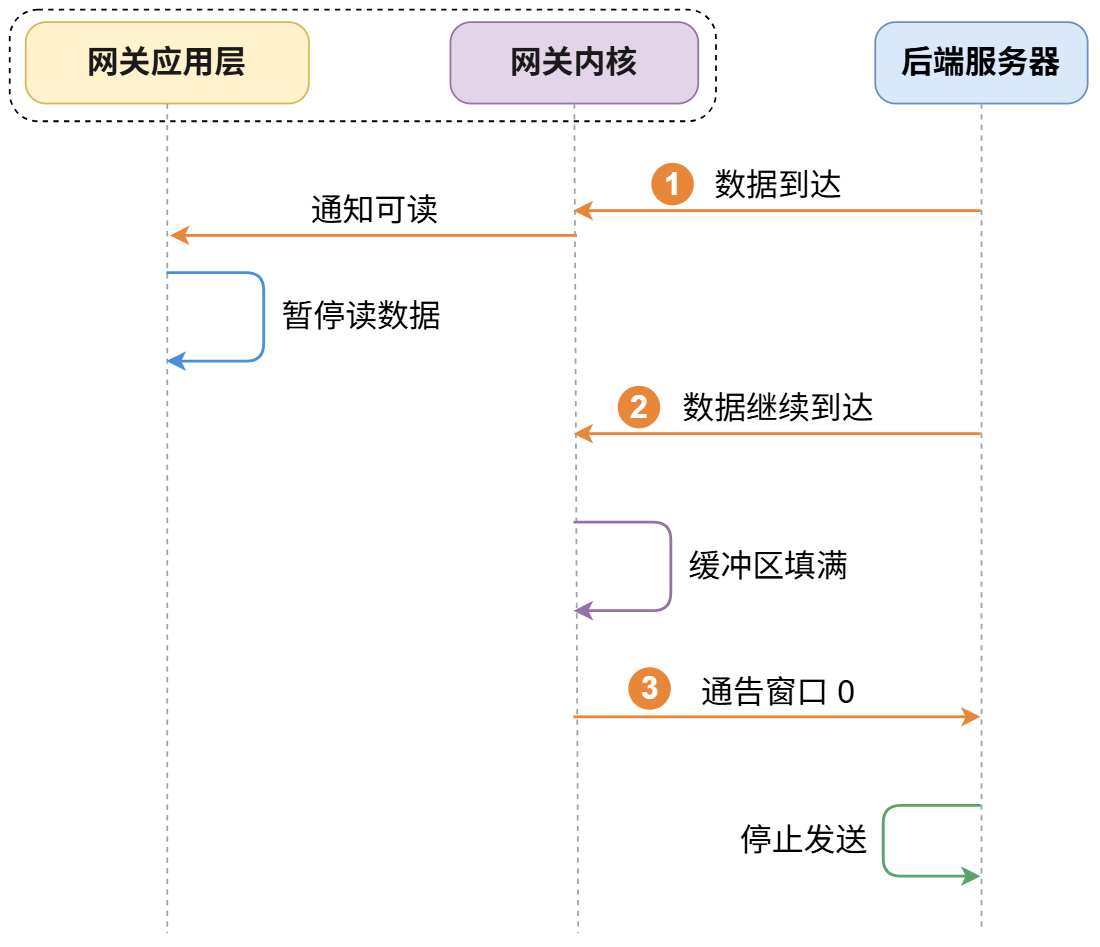
- 网关不再调
read,后端服务器发来的数据继续进入这条连接的内核接收缓冲区,却没有人取走; - 内核接收缓冲区被填满,剩余空间变成 0;
- 这个剩余空间会被写进 TCP 报文的窗口字段,随着 ACK 一起发回后端服务器,此时窗口值是 0,也就是零窗口更新;
- 后端服务器的 TCP 协议栈收到 0 窗口,停止发送数据;
客户端慢速,最后停下来的是后端服务器。谁产生的数据,压力就还给谁。
网关不用再替后端服务器扛内存,它只要什么都不做就行了。
网关只做了"暂停调 read"这一件事,后面几步全是 TCP 协议栈自己完成的。
小结
- 客户端收得慢,数据积压在网关发往客户端的应用层发送缓冲区里;
- 这个缓冲区没有上限,一直积压下去就是内存耗尽,进程被 OOM 杀掉;
- 唯一的出路是不再从后端服务器读,用 TCP 的零窗口让后端服务器自己停下来。
原理其实一句话就能说清楚。然而"对于不再从后端服务器读数据",真正要实现这个功能,还是挺复杂的。这也是很多人看网络库代码,有时候一头雾水的原因,太细节了,无法把控全貌。
而且在 LT 水平触发和 ET 边缘触发模式下,实现方式还不一样。
二、LT 和 ET 两种触发模式,决定了停读怎么实现
连接上有数据可读,网关如何感知的?
结论是:epoll_wait 返回时,会通知 fd 是否有事件可读。
网关是事件驱动的,主循环阻塞在 epoll_wait 上。一旦连接可读了,epoll_wait 就返回这条连接的可读事件,事件循环接着调用这条连接的读事件处理函数,在读处理函数里 read 真正地读取数据
如果 epoll_wait 不返回这条连接的事件,那读处理函数就不会被调用,这条连接上的数据也就不会被读取。
所以"停止从后端服务器读"这件事,本质上是让 epoll_wait 别再返回后端服务器那条连接的可读事件。然而 epoll_wait 什么时候返回、返回多少次,是由两种触发模式决定的。
LT 和 ET 的通知次数有什么区别?
LT 只要内核缓冲区里还有数据就会一直触发返回,ET 只在数据刚到达的时候返回一次。
拿后端服务器那条连接举例。它的内核接收缓冲区里有一批数据没被读走,网关在 epoll 上给它注册了 EPOLLIN。
- LT 水平触发:只要这批数据还留在内核接收缓冲区里,那
epoll_wait不断返回。只要不读,就一直返回。
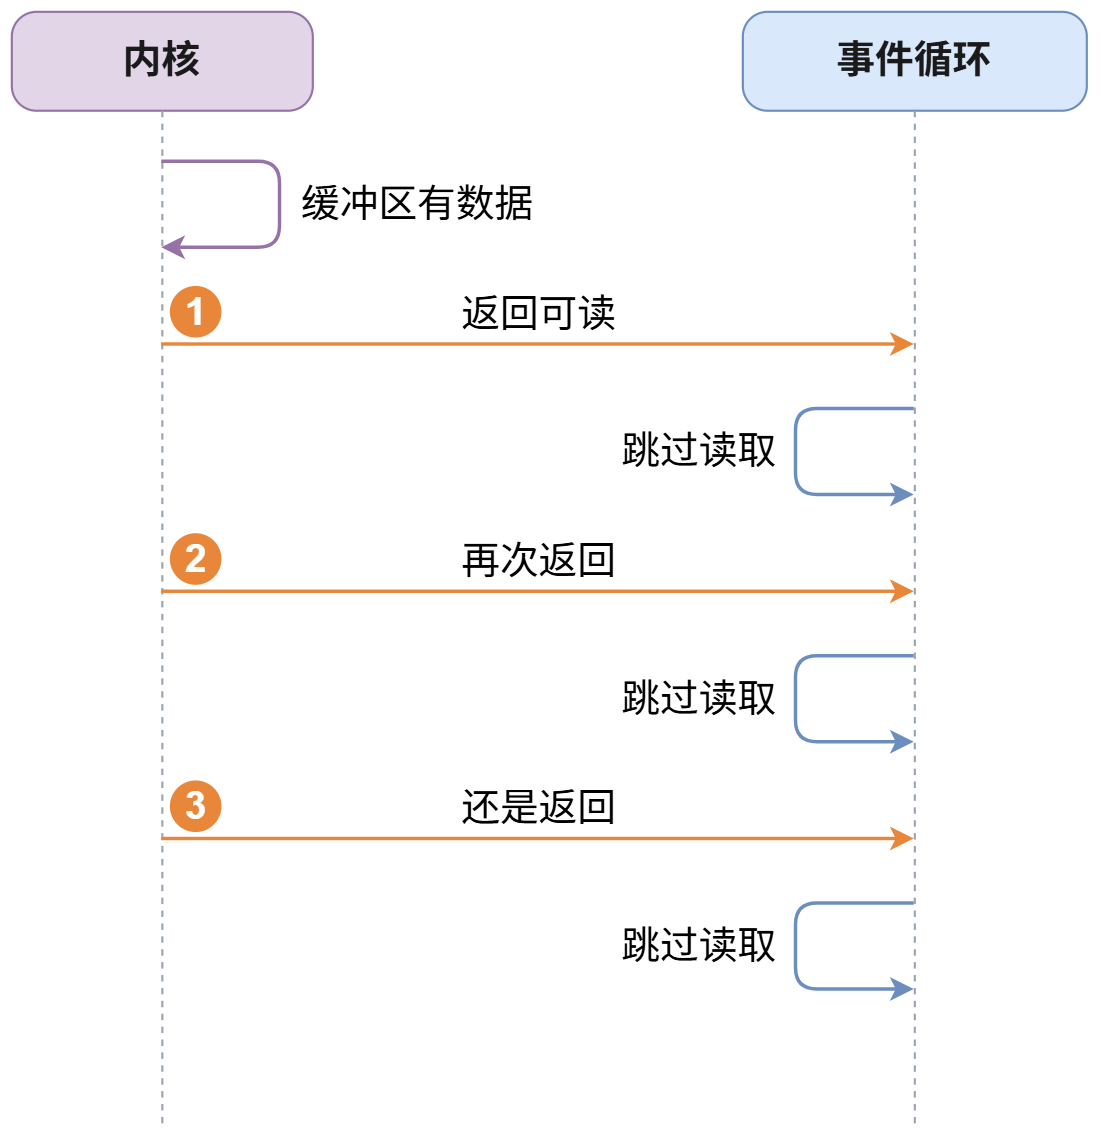
- ET 边缘触发:只在数据从无到有时返回一次。如果读事件处理函数里面不去读取数据,那后面的
epoll_wait不会再返回这条连接,数据留在了内核接收缓冲区中。除非又有新数据到达,缓冲区里的数据量再次发生变化,否则数据就停留在内核的缓冲区里。
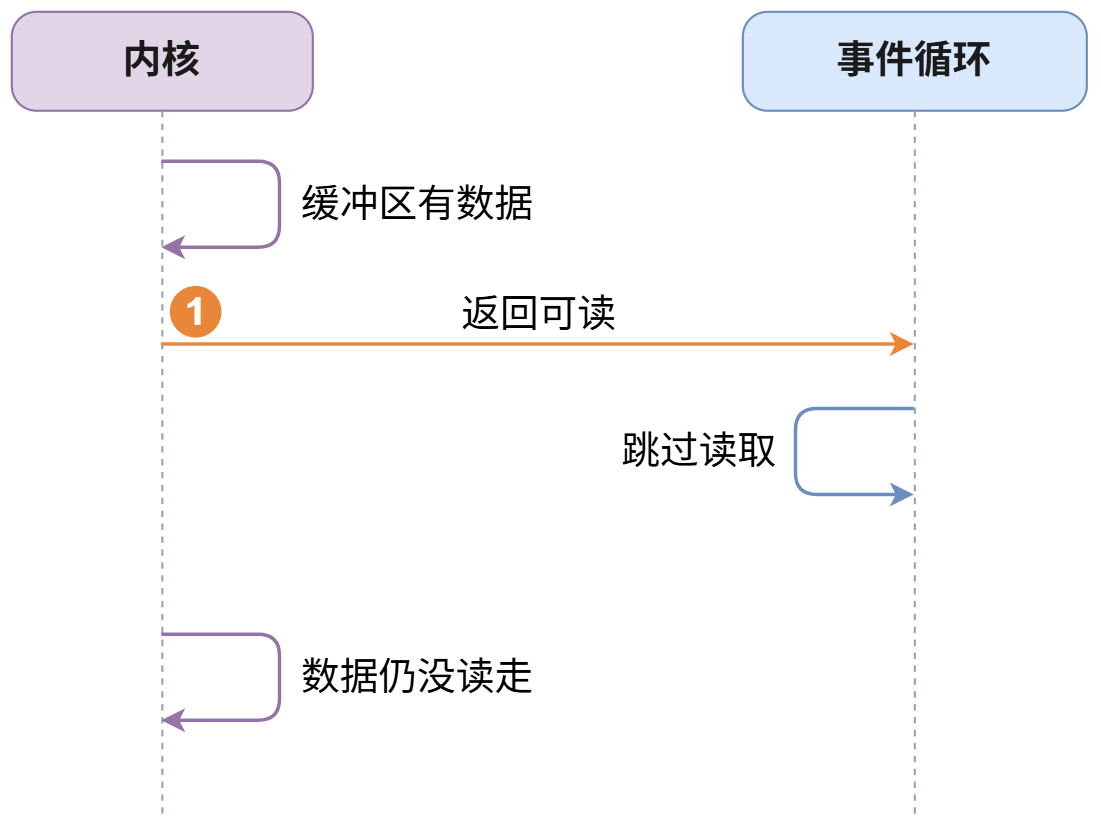
LT 水平触发,看的是"缓冲区里有没有数据",ET 边缘触发看的是"缓冲区里的数据有没有变化"。平时用哪种都能把数据读完,差别不大。可一旦你打算故意不读数据,那两者的区别就出现了。
收到通知却不读,LT 和 ET 分别会怎样?
LT 事件循环会空转,会不断消耗 CPU;而 ET 对 CPU 消耗没影响。
LT 下不读数据,不断触发读事件。 读处理函数被调用了,代码里却不调 read,数据原封不动留在内核接收缓冲区里。epoll_wait 会不断地返回,又调一次读处理函数,又不读数据。中间没有任何等待,类似于死循环了。CPU 利用率一直居高不下。
我之前线上运营 CDN 服务器时遇到过同类问题:fd 忘记关闭,句柄泄露。而这个 fd 的内核接收缓冲区还有数据,epoll_wait 一直返回通知应用层这个 fd 可读。CPU 的 sys 占比一度高到 40%。
所以 LT 下要真正不去读数据,只有一种方式:那就是改 epoll 上注册的事件,把 EPOLLIN 去掉。 epoll_wait 不再关心这条连接的可读状态,也就不会再返回它的事件了。
ET 下不读,就已经停了。 只在数据到达时返回一次,事件循环中不去读取数据,后面的 epoll_wait 再也不会返回这条连接的可读事件。不需要改任何东西,事件循环会停止空转。
ET 边缘触发方式下,既然 epoll_wait 不会再返回这条连接的可读事件,也就没有任何地方能再触发它的读处理函数。而数据还存储在内核接收缓冲区里,什么时候读取,这得网关自己维护。后续需要读数据的时候主动去读,而不是等待事件触发。
小结
- 网关靠
epoll_wait的返回来驱动,epoll_wait不返回这条连接,就没有代码去读它; - LT 只要内核接收缓冲区里有数据就每轮都返回,ET 只在数据刚到达时返回一次;
- LT 想停读,必须去改 epoll 上注册的事件,否则事件循环空转烧 CPU;
- ET 不读就等于停了,一次系统调用都不用花,但得自己记住还有数据没读。
由此可以看出,解决速度不匹配问题,LT 和 ET 处理方式是不一样的。先看 LT 水平触发方式下是如何处理的。
三、LT 模式下的方案:把读事件从 epoll 中摘掉
如何判断客户端慢速了?
看网关发往客户端方向这条连接,它的应用层发送缓冲区里积压了多少数据。
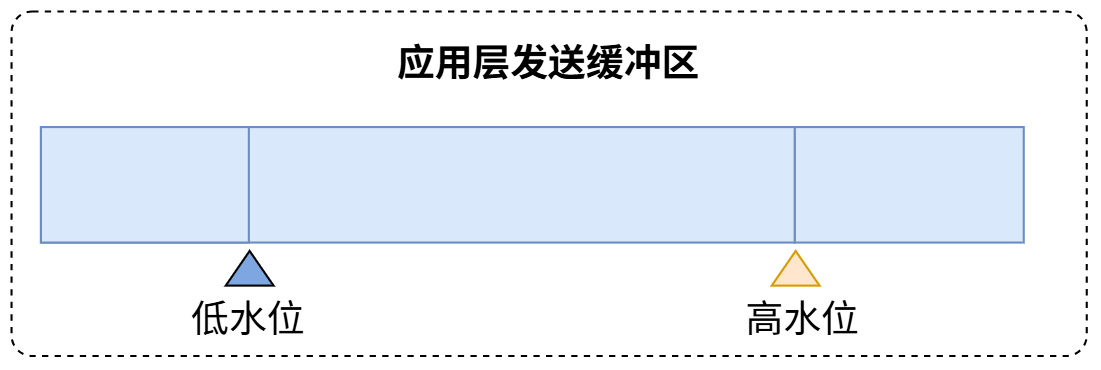
给这个缓冲区设一条高水位线,比如 1 MB。每次往缓冲区里追加数据后,网络库比较一下当前的数据量和这条线,越过去了就回调一次,通知上层调用者,客户端慢速,无法将数据发送出去,导致应用层发送缓冲区堆积了。
有两个细节值得说明。
高水位阈值只能由应用层自己设。 内核不统计应用层攒了多少数据,它只知道自己那个内核发送缓冲区满没满。应用层攒了 1 MB 还是 100 MB,内核一无所知,也不会给任何提示。
回调只在越过去的那一次触发。 不是超过高水位之后每次写都触发。这一点很重要,否则积压期间每写一次就回调一次,回调本身就成了负担。因此,网络库内部就要记录,只有在发送缓冲区中已有数据 + 本次待发送的数据,总长度越过阈值时才触发。成熟网络库的连接对象上那个高水位回调接口,就是干这个用的。
客户端积压,如何解决呢?
解决方案是:客户端方向的发送缓冲区,高水位触发后,在高水位回调函数中,把后端服务器的连接 fd,从 epoll 中移除。
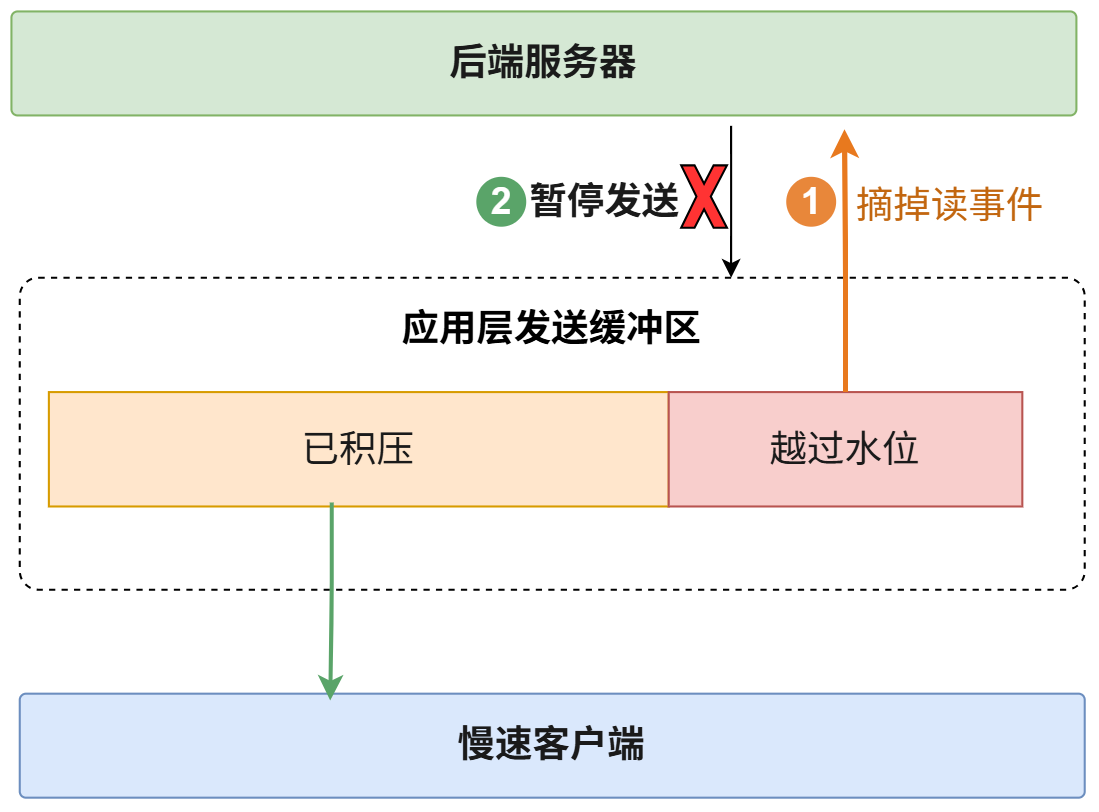
为什么摘掉的是后端服务器的读事件?
因为数据是从后端服务器那条连接读进来的,要让发往客户端方向的积压停止增长,就得在源头上进行控制,让源头停止发数据。
这是最让人疑惑的地方:积压发生在客户端这一侧,被摘掉读事件的却是后端服务器那条连接。 两条连接耦合在了一起。
数据积压在发往客户端的应用层发送缓冲区里,说明客户端一时半会儿收不完。这时候网关能做的不是催客户端快点收,客户端的带宽就那么多,催也没用。网关能做的是别再往这个缓冲区里添新数据,而新数据的来源只有一个,就是后端服务器那条连接上的 read。
摘掉后端服务器的读事件,epoll_wait 不再返回后端服务器那条连接,网关不再调 read,就不会将从后端读取的数据拷贝到客户端方向的发送缓冲区中,那客户端方向的发送缓冲区就不会继续涨。
同时后端服务器那条连接的内核接收缓冲区填满后,会给后端服务器发送一个零窗口通知,后端服务器也停下来了。
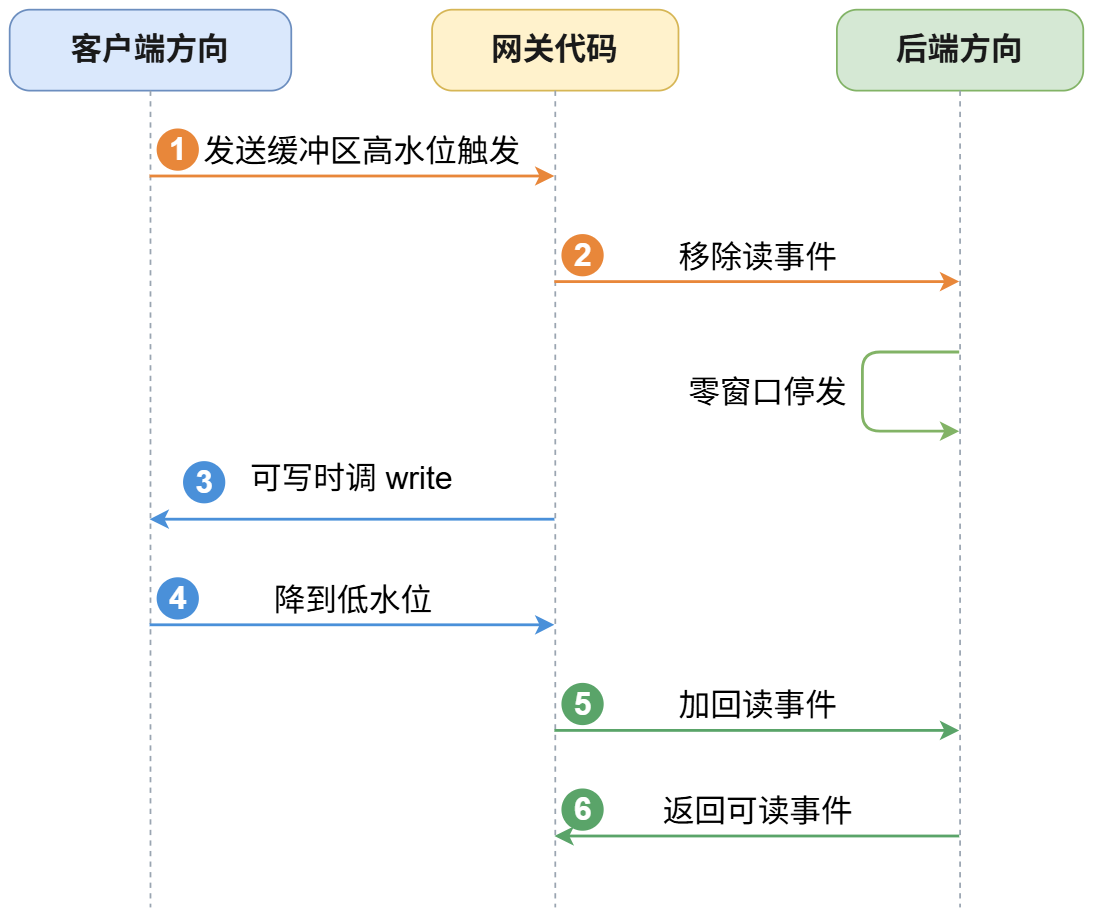
将后端服务器的 fd 从 epoll 中移除,一个动作解决了两件事。
具体怎么移除,是一次 epoll_ctl 调用,但有两种写法:
- 把整个 fd 从 epoll 中删除:注册的事件清空之后,直接用
EPOLL_CTL_DEL摘掉 fd,此时这个连接的任何事件都不会再触发。 - 只去掉 EPOLLIN,保留 EPOLLRDHUP:
epoll_ctl用EPOLL_CTL_MOD,这条 fd 还留在 epoll 里,只是不再关心它可不可读;
两种写法都能让 epoll_wait 不再返回这条连接,但还是有差别的。
断开消息。 如果选的是把整个 fd 从 epoll 中删除,那么暂停的这段时间里,EPOLLRDHUP 和 EPOLLERR 也收不到了。后端服务器已经断开连接,网关却要等到读事件加回去之后才能发现后端已经断开,中间这段时间一直在为一条已经断开连接保留资源。
改成用 EPOLL_CTL_MOD ,只去掉 EPOLLIN、保留 EPOLLRDHUP,同样是一次系统调用,断开消息却不会丢。这是一个纯粹的实现选择。
恢复读取,如何处理?
恢复的过程是这样的。客户端陆续把数据收走,网关在客户端方向的可写事件处理函数中不断调 write,应用层发送缓冲区里的数据越来越少。降到设定的水位以下时,网络库回调一次,网关在低水位回调函数中,调 epoll_ctl 把后端服务器那条连接的读事件重新加入到epoll。
因为读事件重新注册到 epoll,下一轮 epoll_wait 立刻就会返回这条连接的可读事件。
关键在于 LT 的语义:它看的是"内核接收缓冲区里现在有没有数据",不是"数据是什么时候到的"。那批数据在内核接收缓冲区里躺了多久都没关系,读事件一加回去,下一轮 epoll_wait 照样把这条连接返回出来。
恢复这件事由内核兜底,代码这边不需要额外做任何补救。 这是 LT 这条路最省心的地方。
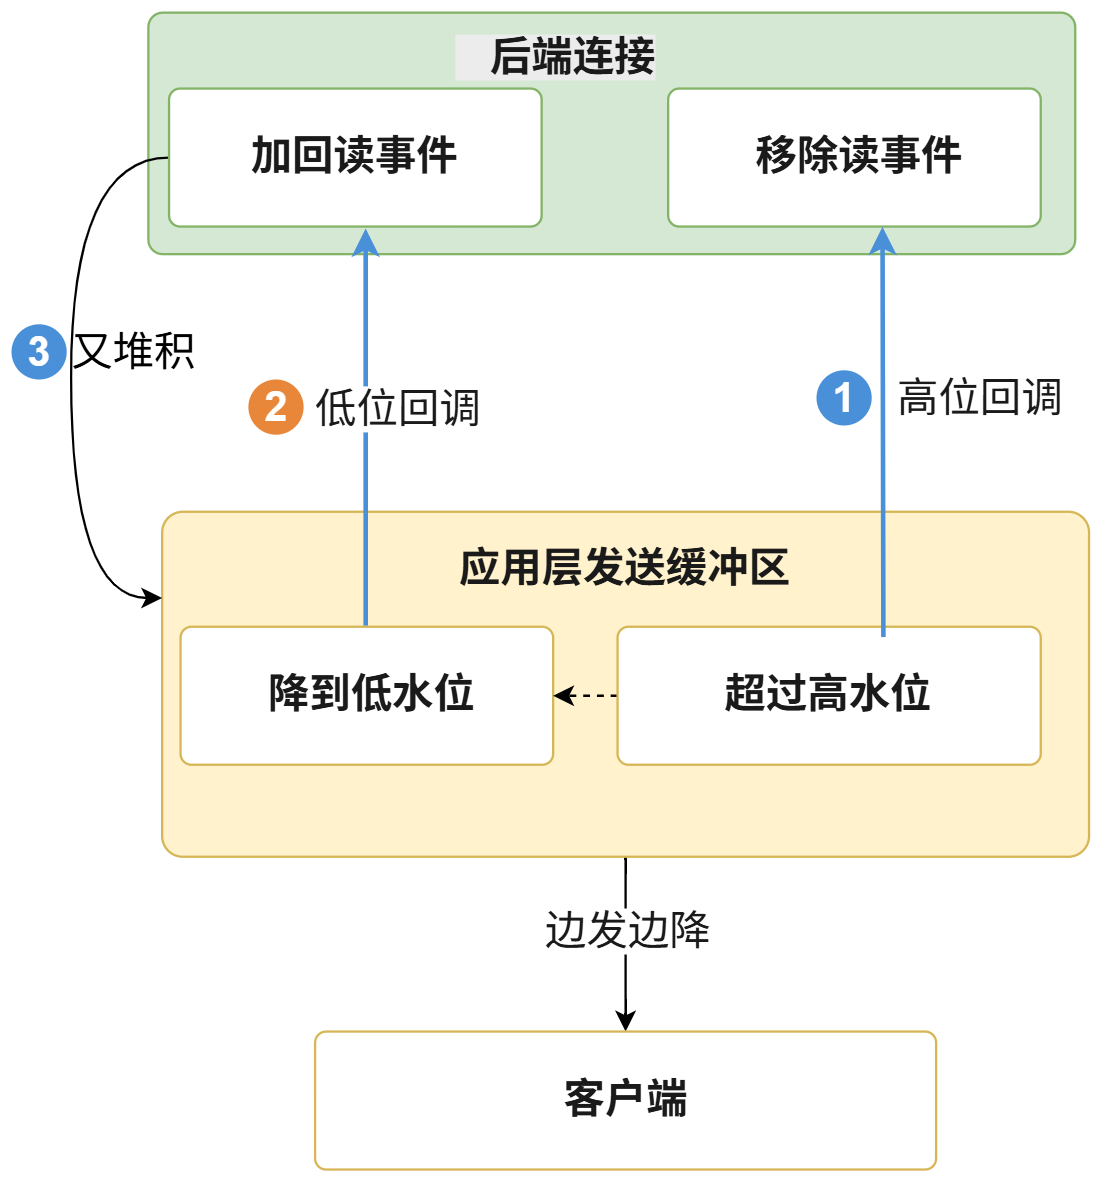
从图中可以看到,摘掉和加回是一个反复循环的过程:,每转一圈就是两次 epoll_ctl。
至于降到什么程度才恢复,有两种做法:
- 等缓冲区里的数据全部发完再恢复:实现最简单,一个高水位就够了。代价是吞吐忽高忽低,积压期间完全不读,发空之后又猛读一大批,曲线是锯齿状的;
- 设高低两条水位线:比如高水位 1 MB、低水位 512 KB,降到低水位就恢复读取。客户端方向的发送缓冲区里始终留着一些待发数据,客户端那边不会出现空档,吞吐平滑得多。
一个比较成熟的网络库,基本上都采用高低水位的实现。
这种方案有什么缺点吗?
上下游速度不匹配时,会多两次系统调用。
系统调用。 越过高水位摘一次读事件,降到低水位再加回来一次,一个拥塞周期就是两次 epoll_ctl。偶尔发生一次可以忽略不计。可网关这类程序,客户端和后端服务器速度对不上是天天在发生的常态,积压了又发完,发完又积压,一天到晚反复。
LT 水平触发下,多两次系统调用,这是躲不掉。只要选了 LT,想要停止读取数据就必须改 epoll 上注册的事件,一旦修改就需要系统调用。
小结
- 用应用层发送缓冲区的高水位线,判断客户端是不是慢速了;
- 客户端慢速导致发送缓冲区积压,移除的是后端服务器那条连接的读事件
- 恢复由内核保证,读事件重新加入到 epoll,可读事件会重新触发,不会漏掉数据;
- 缺点是需要两次
epoll_ctl系统调用,移除方式不对,还会丢掉断开消息。
LT 水平触发方式下,代码写起来也简单,就是那两次系统调用躲不掉。如果换成 ET,这两次系统调用开销能省掉吗?
四、ET 模式下的方案:用 ready 标记还有数据没读
ET 边缘触发模式下,做法是:与后端服务器这个方向,可读事件触发时,应用层不调 read,那 epoll_wait 就不会再返回这条连接的可读事件。没有返回,就没有代码去读它, 也就不会将后端的数据拷贝到客户端的发送缓冲区,速度自然就降下来了。
所以在 ET 这条路上,与后端连接这个方向,可读事件触发时,要做的事情是:检查客户端方向的应用层发送缓冲区是否积压了。如果积压,不改 epoll 上注册的事件,不调任何系统调用,读处理函数里直接返回。
是不是感觉有点耦合了,但这是无奈之举。
后端服务器那边怎么停下来?
和 LT 处理方式是一样的:后端服务器那条连接的内核接收缓冲区填满后,会给后端服务器发送一个零窗口通知,后端服务器的 TCP 协议栈停止发送。
内核只通知一次,网关靠什么记住还有数据没读?
靠一个自己维护的用户态标记,这个标记通常就叫 ready,很多网络库都使用这个名字作为标记
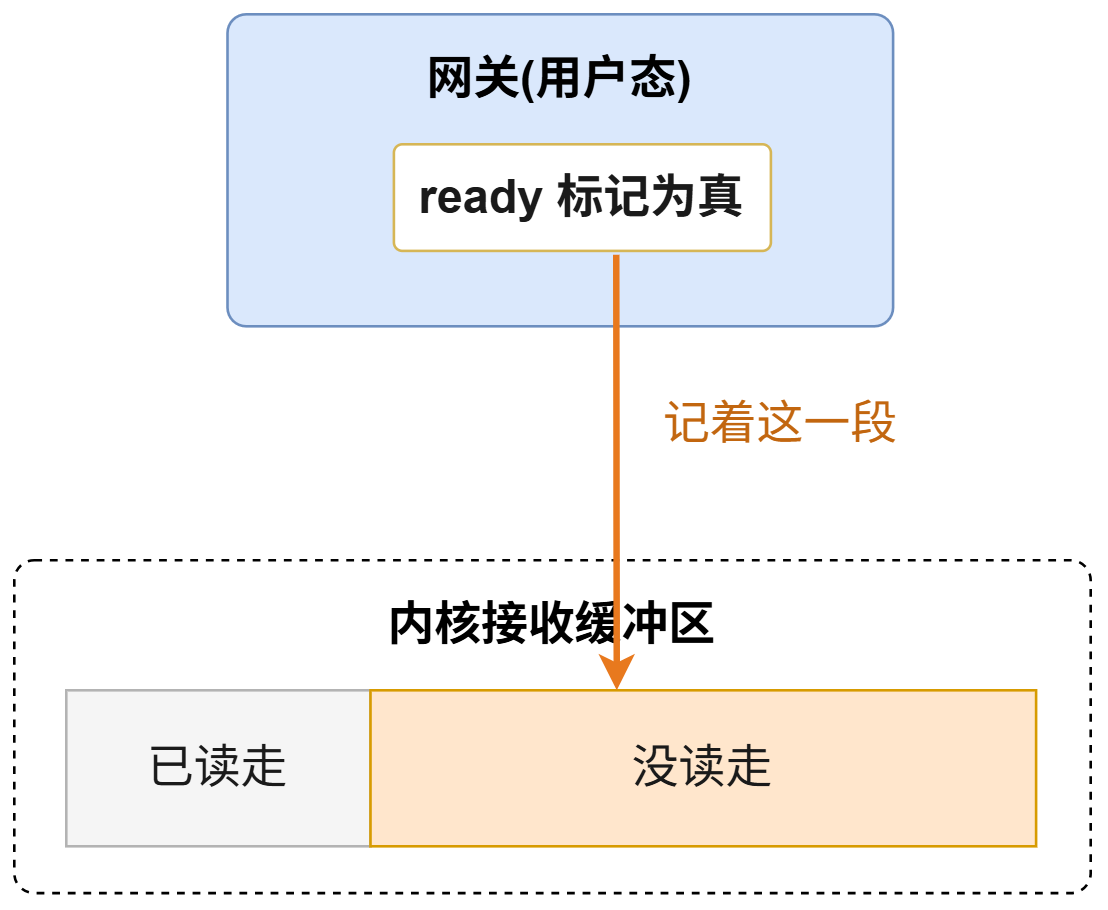
先看看不记会怎样。那批数据还留在后端服务器那条连接的内核接收缓冲区里,可数据到达的那一次通知已经过去了,epoll_wait 不会再返回这条连接。后端服务器又因为零窗口停止了发送,不会再有新数据到达,也就不会有新的通知。
没有通知,也没有新数据,这条连接上的数据就再也不会被读走。 除非网关主动回来调一次 read。
ready 标记的就是这件事:后端服务器那条连接上还有没读走的数据。它的维护规则很简单:
epoll_wait返回这条连接的可读事件时,把 ready 置为真;- 循环调
read,一直读到返回EAGAIN,说明内核接收缓冲区已经读空,把 ready 置为假; - 因为客户端积压而中途停下来时,ready 保持为真,记着这里还有活没干完。
以后网关想读后端服务器的数据时,就可以不需要 epoll_wait 触发了,只要这个标记是真,说明内核接收缓冲区里还有数据,直接调 read 就能读到。
网关知道"ready 为真,还有数据没读",那什么地方读取数据呢?
答案是:与客户端方向,客户端可写事件触发时,在写事件回调里,读取来自后端服务器的数据。
你没看错,确实是客户端的可写事件回调里,读取来自后端服务器的数据。
因为重新触发后端服务器读取的,是客户端那条连接的可写事件。
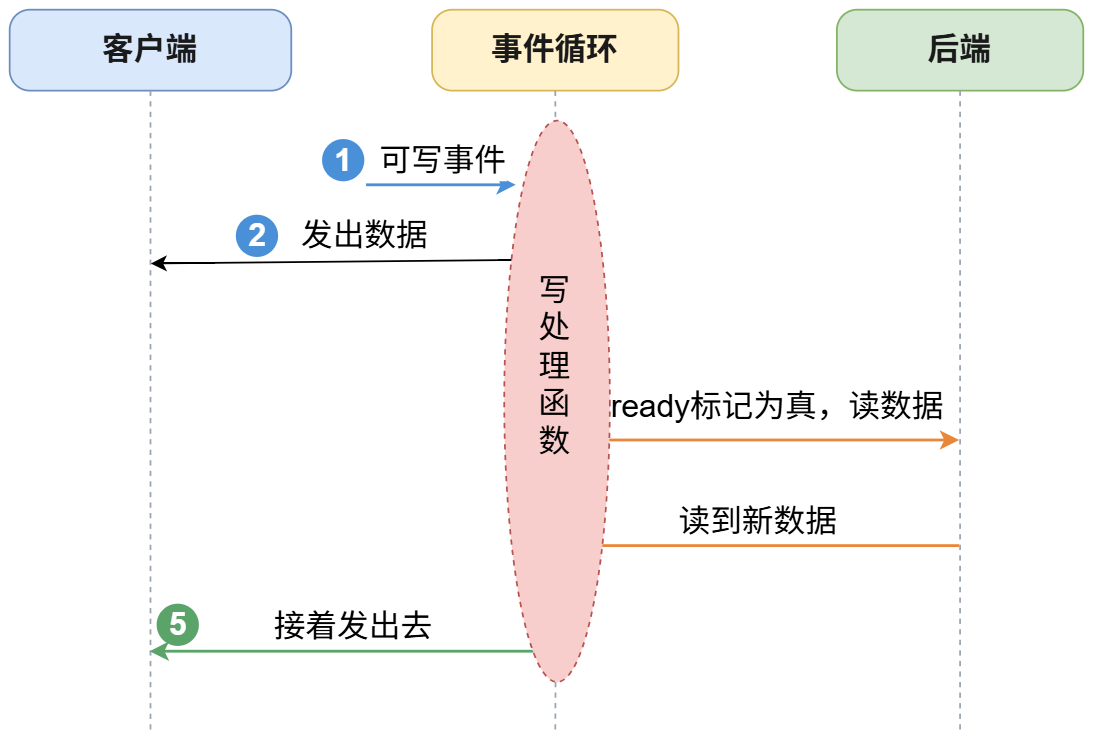
整个恢复读取的过程是怎么样的?
客户端收走一批数据,客户端那条连接的内核发送缓冲区腾出空间,epoll_wait 返回这条连接的可写事件,事件循环调到它的写处理函数。
写处理函数先调 write,把应用层发送缓冲区里积压的数据发给客户端,能发多少发多少,直到 write 返回 EAGAIN 或者缓冲区发空为止。
紧接着,在同一次处理里,转身去看后端服务器那条连接的 ready 标记。标记是真,就调 read 把数据读上来,再调 write 发给客户端。写一轮,读一轮,两条连接在同一个函数里来回切换,直到 ready 变成假,或者客户端那边又写不动了为止。
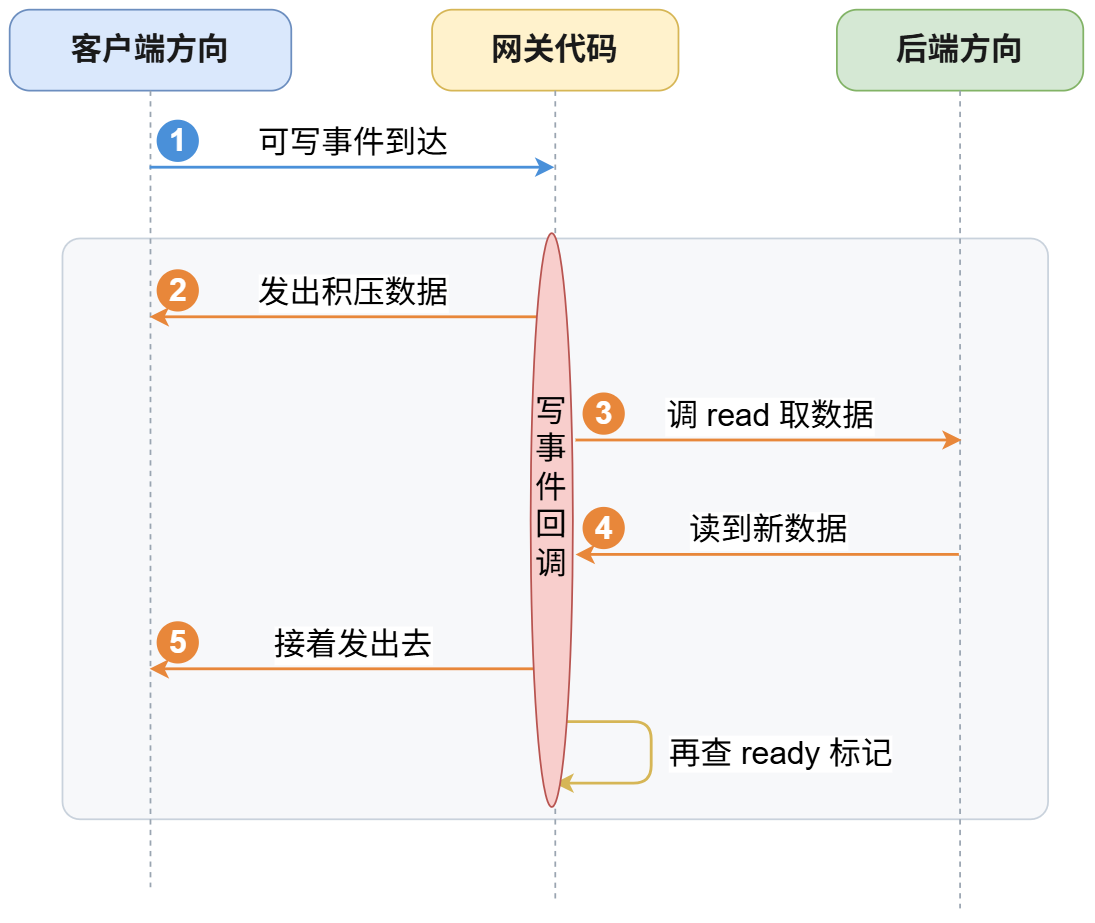
边缘触发方式下,需要读和写,必须在同一个循环里处理,为什么?
如果读和写分在两个独立的处理函数里,这条链就断了。 后端服务器那条连接的读处理函数只由 epoll_wait 触发,可 epoll_wait 已经不会再返回它了。客户端那条连接的写处理函数只管发数据,发完就退出,谁也不会去碰那个 ready 标记。数据就永远停在内核接收缓冲区里。
所以 ET 这条路上,读和写必须放在同一个循环里,这不是风格问题,是这套方案能跑起来的前提。
虽然客户端的写,和后端的读耦合在了一起,但这是将两者关联起来的无奈之举,必须为两者的衔接搭建一座桥梁。
触发点在客户端那条连接上,可真正被带动起来的是后端服务器那条连接。
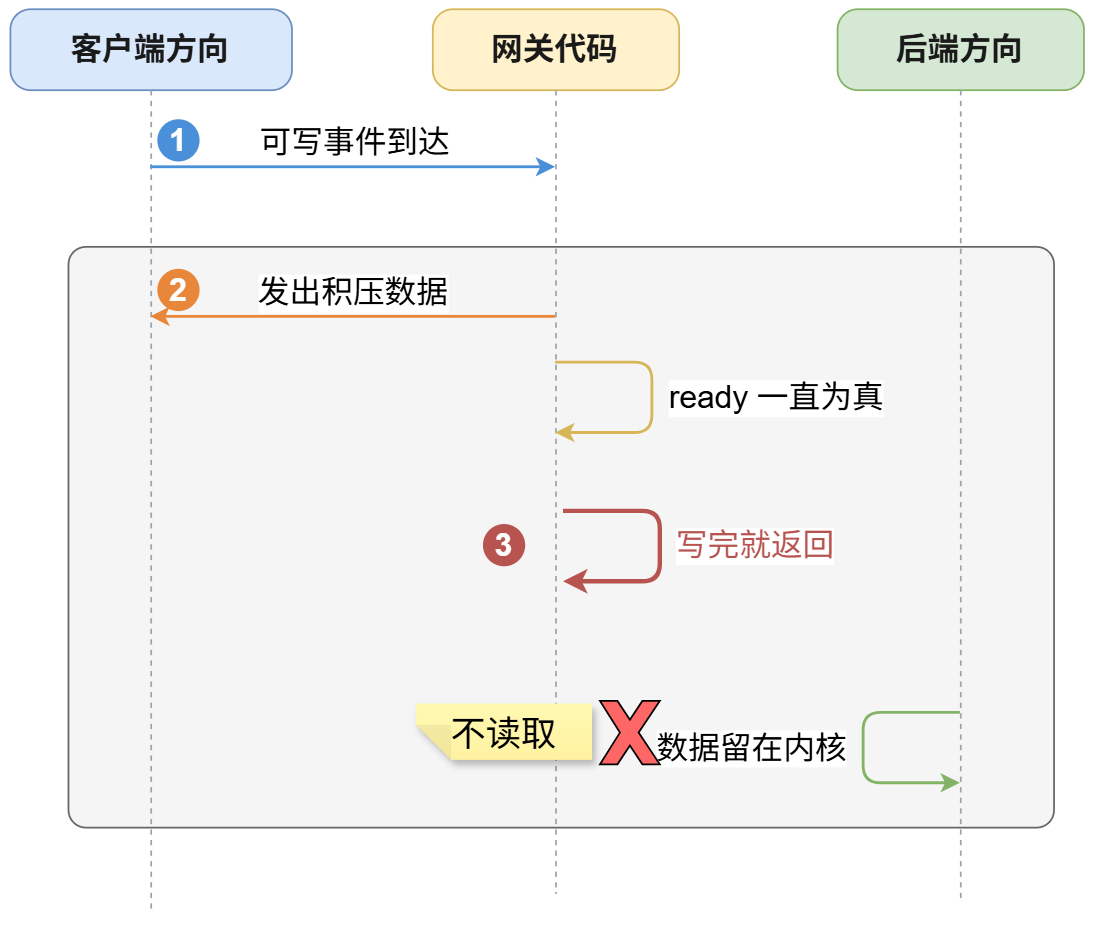
这种方案有什么缺点?
只要有一条代码路径漏了重入,这条连接上的数据就再也读不走了。
对比一下就很清楚。LT 那条路上,就算你忘了把读事件加回去,只要事件还在 epoll 里,内核就会不停地返回这条连接,问题会以 CPU 空转的形式立刻暴露出来。ET 这条路上没有这样的兜底。ready 标记还是真的时候退出了处理流程,又没有别的地方重新进来,这条连接就停在那里不动了,内核不会来提醒你。
这类故障排查起来特别麻烦。 连接还在,没有报错,没有断开,日志里一切正常,客户端那边就是收不到后续数据,一直等到超时。你去看进程状态,CPU 不高,内存不涨,什么异常都没有。
容易漏掉的路径通常是这几处:
- 客户端那条连接出错或者半关闭时,走了错误处理逻辑,直接返回,没有检查 ready 标记;
- 客户端方向,应用层发送缓冲区发完之后,提前退出了,没有检查 ready 标记,从后端服务器读数据。
这些分支平时可能跑不进来,压测也未必能覆盖,往往要等到线上出现连接卡住才能发现。这也是 ET 边缘触发方式复杂的其中一个原因。
小结
- ET 边缘触发方式下,停止读数据,一次系统调用都不花,这是 ET 本身机制决定的
epoll_wait只在数据到达时返回一次,所以要用 ready 标记还有数据没读;- 靠客户端那条连接的可写事件重新触发后端服务器的读取,因此读取后端和给客户端发送数据必须写在同一个循环里,看着耦合了,但必须这么做;
- 缺点也明显,没有内核兜底,漏一条代码路径,这条连接上的数据就再也读不走。
两种方案都能解决上下游速度不匹配问题,该如何选择呢?
五、两种方案怎么选?
为什么网关通常都用 ET 加 ready 标记?
因为对网关来说,积压和恢复是常态,省下来的系统调用累积起来很可观。
网关服务器干的就是这件事:客户端和后端服务器速度不匹配,在积压与发送之间反复进行。省掉的那两次 epoll_ctl 系统调用,并发场景下,累积起来就是实打实的 CPU 提升。
代表实现是 Nginx、Apache Traffic Server 这一类。
为什么通用网络库反而坚持 LT?
通用网络库面对的是成千上万个业务开发者,他们写的是 Web 服务、RPC 服务、游戏服务器。这类程序,客户端和后端服务器速度不匹配的情况会比较少,两次 epoll_ctl 系统调用的开销也就可以忽略了。
另外,"漏一条代码路径,数据就再也无法读取了。这种故障,对不熟悉网络库内部实现的使用者来说,排查成本非常高。
代表实现是 muduo、libevent 这一类。
两条路横向对照一下:
| 维度 | LT 加改 epoll 事件 | ET 加 ready 标记 |
|---|---|---|
| 触发模式 | 水平触发 | 边缘触发 |
| 停读要做什么 | 调 epoll_ctl 去掉 EPOLLIN | 什么都不做 |
| 状态记在哪 | 内核的事件注册表里 | 用户态的 ready 标记里 |
| 每个拥塞周期的系统调用 | 两次 epoll_ctl | 零次 |
| 恢复靠什么触发 | 加回读事件后由 epoll_wait 返回 | 客户端连接的可写事件 |
| 漏了会怎样 | CPU 空转,问题立刻暴露 | 连接静止,无报错无日志 |
| 典型代表 | muduo、libevent | Nginx、Apache Traffic Server |
两种方案,其实是同一个机制,速度不匹配时,不再从后端服务器读数据,TCP 的零窗口让后端服务器停止发送数据。
六、两种方案下的缓冲区如何设计?
应用层收发缓冲区,有两种实现。一种是每条连接各自一个收发缓冲区;还有一种是转发共用一个内存池。
每条连接自带一份缓冲区。 客户端那条连接的应用层发送缓冲区,和后端服务器那条连接的应用层接收缓冲区,是两个互不相干的对象,谁也拿不到对方的状态。客户端这边积压了多少,后端服务器那边完全看不见。想让它们联动,只能人工搭一座桥:在客户端这边装一个高水位回调,在回调里去操作后端服务器那条连接。那一整套代码就是这座桥。
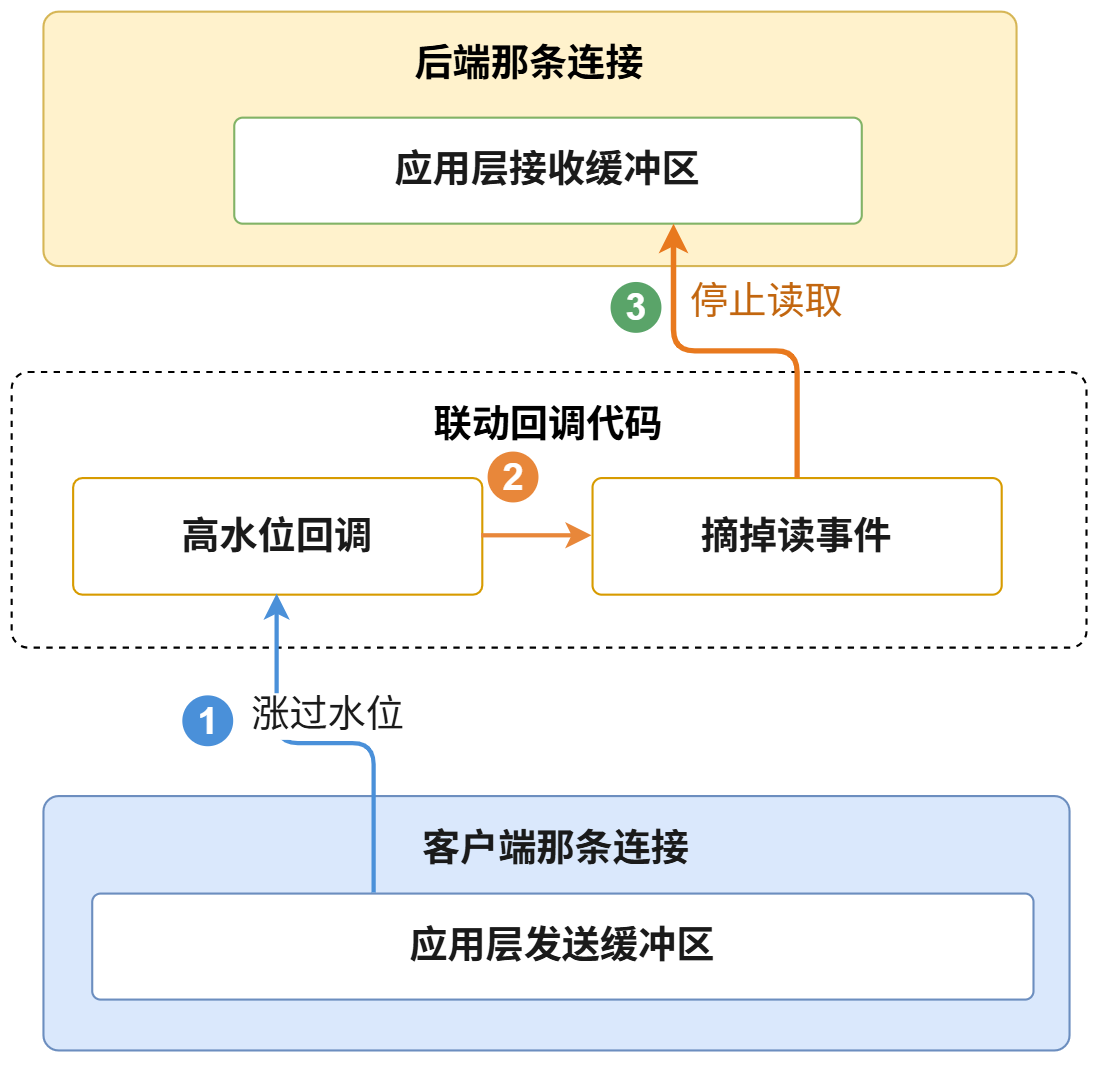
转发共用一个内存池。 从后端服务器读进来的那块内存,直接就是要发给客户端的那块内存,中间不做拷贝。客户端收得慢,这块内存就留在待发送队列里回收不了。内存池里没有空闲内存了,网关也就没法再从后端服务器读数据。
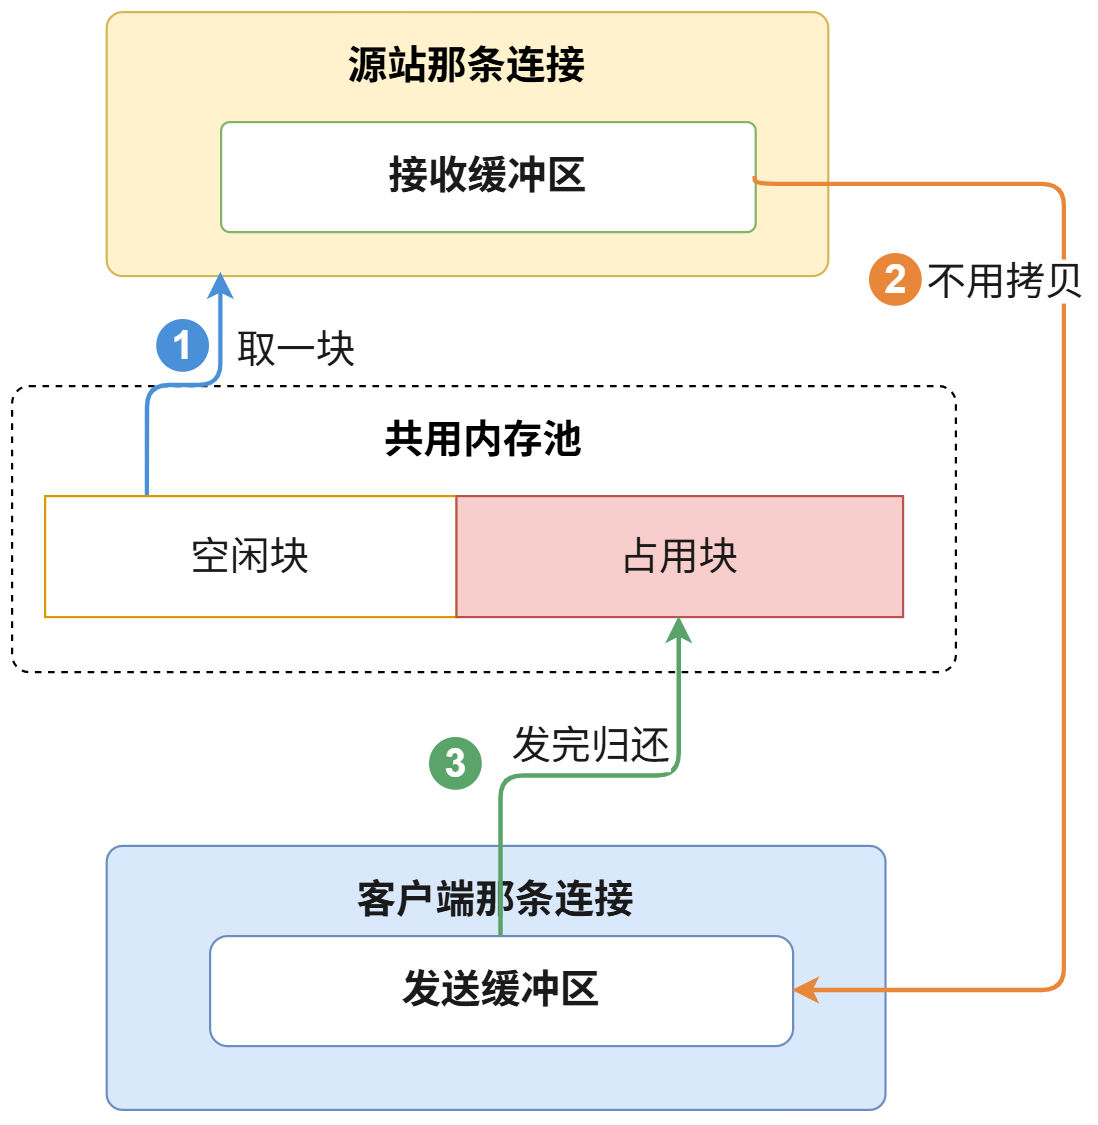
客户端积压和无法从后端服务器读取数据,在共用一个内存池这种结构下,本来就是同一件事。客户端方向和后端方向的缓冲区,全部来自内存池。内存池满了,自然不会从后端读取数据,不需要任何额外的联动代码,就能解决速度不匹配问题。
两种缓冲区实现方式,和 LT、ET 完全独立,可以自由组合。 LT 为每个连接配置缓冲区、ET 共享内存池是比较常见的搭配。但也不一定,不存在谁绑定谁。
总结
后端服务器发送数据很快,客户端慢速,那网关接收到的数据先保存到哪里?
答案是先缓存到网关发往客户端方向的,应用层发送缓冲区。但不能一直缓存,唯一的解决方式是不再从后端服务器读,让后端方向的内核接收缓冲区满后、发送零窗口通告给后端,后端服务器自己就停止发送。
- LT 水平触发,改 epoll 事件:内核的事件注册表里移除 fd。恢复时重新注册到 epoll,
epoll_wait重新返回可读事件,不会漏。缺点是需要两次epoll_ctl系统调用。另外,整个 fd 都从 epoll 中移除,会在暂停读数据期间丢掉连接断开消息; - ET 加 ready 标记:用户态维护。暂停读数据,一次系统调用都不用。代价是没有内核兜底,得自己保证每条代码路径都能覆盖,漏一条这条连接上的数据就可能再也无法读取了。
- 应用层缓冲区如何设计:每条连接自带收发缓冲区,就得人工写一套回调搭建桥梁;而共用一个内存池方案,内存池空了自然就不会从后端服务器读数据,天然地解决背压问题。
有个地方最容易搞混:
- 积压发生在客户端这一侧,要从 epoll 中移除的却是后端服务器那条连接的读事件,两条连接是耦合在一起的;
写在最后
客户端和后端服务器速度不匹配,这在网关、代理是经常出现的场景。这就是业界常说的背压(backpressure)
在看懂了 LT 和 ET 解决速度不匹配的方案后,再去读任何一个网络库代码,你就不会看到一堆代码细节而一头雾水了,对代码的把控也会有个清晰的认识。
我尽量站在读者的角度把来龙去脉讲清楚了,但每个人理解不一样,还是会有疑惑的地方。有任何疑问,我们评论区里交流。